2022年2月22日 星期二

好站 : GrandmaCan - 我阿嬤都會 (Pyhton 教學頻道)

今天在 Youtube 上發現這個 Python 教學頻道, 說明淺顯易懂, 其內容從入門到近都有, 除了 Python 之外, 還有網頁爬蟲, HTML 與 Javascript 教學等, 很值得一看 : 


例如下面是 4 小時的 Python 入門教學 :


momo 買書 1 本 (Pandas資料清理、重塑、過濾、視覺化深度強化式學習)

今天在 momo 買下面這本 Pandas 的書 : 


滿 490 元免運費 (可惜 momo 幣尚未入帳). 


其實還想買另外兩本書 :


此書母校圖書館有, 先借來看看, 值得擁有再買. 屆時 momo 7 折優惠已過可在博客來買 : 


博客來 7 折到四月底. 

列入追蹤的第二本是 autoML 的書 :


2022年2月21日 星期一

使用 Web Scraper 擷取網頁 (一) : 安裝瀏覽器擴充程式

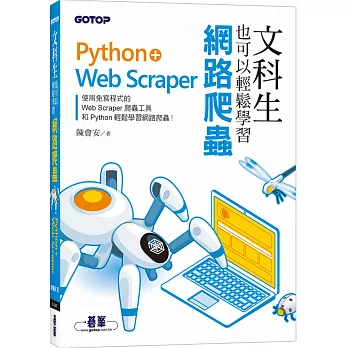
昨天在母校圖書館找到下面這本書 :


Source : 博客來


此書內容分成兩部分, 前半部介紹如何用免費的瀏覽器擴充程式 Web Scraper 來擷取網頁內容, 完全不用寫程式碼, 只要懂一些 HTML 基礎, 即使是文科生也可以利用它輕鬆爬取網頁資料; 後半部則是介紹如何用 Python 寫網路爬蟲, 屬於進階級內容.

首先來安裝 Web Scraper 這個擴充程式, 其官網如下 :


使用者可安裝瀏覽器擴充程式來使用這家公司提供的免費服務, 使用者只能在本機執行 (無法在雲端執行), 可擷取動態網頁與執行 Javascript (亦即可擷取 Javascript 產生的網頁), 但結果只能輸出為 CSV 檔, 不支援 XML 與 JSON. 付費使用者則可以使用更多功能, 價格參考 : 


若要付費使用請先註冊會員 : 


免費的 Web Scraper 支援 Chrome, Firefox, 以及 Edge 等瀏覽器, 以下以 Chrome 為例說明安裝擴充程式的方法, 首先到 Chrome 的應用程式商店網站 : 


在左上方的輸入框搜尋 "web scraper" 就可以找到此擴充程式 


點選此程式進入安裝頁面, 按右方 "加到 Chrome" 鈕 : 


在彈出選單中按 "新增擴充功能" 鈕即可 : 


接下來要將 Web Scraper 固定放在 Chrome 右上角工具列上以方便取用, 點右上角的擴充功能鈕會彈出一個選單, 找到 Web Scraper 後按後面的圖釘鈕, 此擴充程式就會固定在 Chrome 右上角的工具列上了 (蜘蛛網 icon) : 


以後只要點擊這個蜘蛛網 icon 即可檢視 Web Scraper 這個擴充程式的資訊 :


Web Scraper 官網提供了此擴充程式的簡介, 參考 : 


網路上也有許多教學文章, 參考 :

2022年2月20日 星期日

2022 年第 8 周記事

本周菁菁開學, 我又要開始接送上下學了, 但這周下午大都是水某去接. 二哥則是下周開學, 這學期的課有微波與 DSP, 都不是容易的科目. 週五收到上學期成績單是第二名, 被他的好朋友超越, 但研究所推甄總排名還是第一. 

週五晚上整理臥房書架上的電子零組件箱, 把常用零件模組重新分類, 發現很多買來都沒有馬上測試, 要用的時候還得去找原賣家要資料有點麻煩. 最近發現房門樞紐會發出怪聲, 檢查發現軸心都快迸出來啦, 趕緊上些潤滑油再拿鐵鎚把軸敲回去, 順便也修好了喇叭鎖, 其實很多覺得麻煩的小事, 只要花點時間 take care 一下就能解決, 而我就是很能拖.

前兩周發現鄉下客廳的掛鐘時針與分針不會動後上網買了新的, 結果週六帶回鄉下要換新時, 那個故障的掛鐘居然正常了, 是知道要被換掉怕了嗎? 真是傻眼. 但客廳我還是掛上新的, 那個復活的舊掛鐘就改掛臥房裡, 這樣看時間也方便. 

不知是否這周寒流來襲加上下雨, 中午去菜園採草莓只採到十幾顆, 但或許也是產期近尾聲了. 

露天購買三用電表 (勾錶)

因之前買的三用電表電源開關按下去螢幕閃一下就消失, 所以上露天找到下面這款 : 


滿 199 免運所以加購 19 元的鱷魚夾一組合計 204 元.

我原本是想買下面這個傳統類比指針式的, 但因上面那款有送驗電起子, 加上從未買過掛勾式的電錶, 再給數位式的一個機會唄, 若還是不行再買指針式的 :


2022年2月19日 星期六

高科大還書 3 本

今天去母校圖書館還 3 本書 : 
No.1 有人預約須還, 此書如其名, 是很白話踏實的 ML 書籍 (適合有 Python 資料科學基礎的 ML 初學者), 本周已在 momo 購買. No.2 是張元翔老師的著作, 我目前還用不到, 先還 (才能拿剛到的 DSP 預約書). No.3 暫時沒用到, 還好有帶去, 因為在架上看到三本不錯的書, 還了這本就能將那三本全數逮捕, 果然人無遠慮必有近憂啊, 呵呵. 

其實還發現一本剛到的 GAN 新書 :


Source : 天瓏


下周要努力讀書還書, 這樣才能借更多的書. 

2022年2月18日 星期五

深度學習之應用課程筆記 (一)

今天開始中午午餐時間不看小說也不看韓劇, 而是上 Youtube 看台大資工系陳蘊儂老師的課程錄影. 這學期開了一門 "深度學習之應用", 本周才剛開始上課, 課程說明影片如下 :


我不是修課學生, 所以只要記下課程日程表即可 : 


下一課是機器學習簡介 (12:05 分) :


此課主要在說明機器學習 programming 與傳統 programming 的差異在哪裡, 傳統 programming 用來解決演算法 (規則) 很明確的問題, 程式只要此演算法明確地寫在程式碼中即可解決問題, 但若問題缺乏明確的演算法或其規則變化很多無法窮舉時 (時不時會出現許多例外), 就是機器學習派上用場的時候了. 

老師以判別一個評論是正面或負面為例來說明, 例如 "I love this product" 是正面; "It 's a little expensive" 是負面等等, 但這些並沒有一個通用與固定的規則可用來給程式做判斷以得到正評或負評的輸出. 機器學習則是以類似人海戰術的方式, 透過餵給它大量的資料讓電腦自動學習內隱的函數. 

機器學習很大部份的精力是花在資料預處理與訓練上. 處理好的資料會被拆成訓練集 (training set) 與測試集 (testing set) 兩部分, 分別用在機器學習的訓練 (training) 與測試 (testing) 兩個階段, 所謂訓練是指將訓練集資料餵給演算法, 以便從模型中挑選出最適合資料的函數 (一個神經網路模型可捏成各種函數), 而測試則是用測試集資料餵給挑選出來的最佳函數, 預測看看輸出是甚麼, 如下圖所示 :


此圖是以判斷評論是正評還是負評為例.


此單元為深度學習簡介, 摘要如下 :
  1. 深度學習網路中間有許多隱藏層串接, 因此它就像生產線一樣, 是由許多小函數堆疊起來的 (stacked functions), 可以模擬很複雜的函數. 不過, 在訓練深度網路時, 我們只要給予它輸入端的樣本以及輸出端的目標即可, 不需要去管它內部那些串接的小函數者怎樣, 稱為 end-to-end training (端對端訓練), 中間隱藏層所代表的小函數會自動學習到資料的特徵 (features 或 representation), 因此深度學習又稱為特徵學習 (representation learning). 
  2. 在語音辨識方面, 傳統的淺層辨識需要先對語音做訊號處理 (DSP) 取得代表該語音樣本特徵的梅爾倒頻譜係數 (Mel-Frequency Cepstral Coefficients, MFCC), 然後透過聲學統計模型 GMM (Gaussian Mixture Model, 一種隱藏式馬可夫機器學習模型) 來辨識出是甚麼語音, 在產出 MFCC 之前都屬於人為決定的過程, 只有 GMM 才是機器學習. 但現代用深度學習來做語音辨識就非常簡單, 不需要 MFCC 的人為 DSP 特徵擷取工程, 而是直接將語音餵給深度網路, 讓它自己擷取特徵, 但代價是需要很多語音資料去訓練. 
  3. 傳統機器學習與深度學習最大的差別是, 前者需要手工 (hand-crafted) 的特徵工程, 而深度學習則不需要, 而是由網路自動學習資料的特徵. 
  4. 深度學習的類神經元結構模仿人類大腦神經元, 基本上是由一個 weighted-summation 函數與一個 activation 函數組成, 最早是在 1960 年代以 Perceptron (感知器) 形式出現, 但它後來被證明無法模擬全部的函數, 直到 1980 年代多層感知器 (Multi-Layer Perceptron, MLP) 被提出來才解決, 但限於當時電腦效能, MLP 因要耗費大量運算時間使其實用性不高. 到了 2009 年後 GPU 被用在類神經網路的計算上, 採用深度學習的語音辨識突破傳統淺層技術的成功率, 2012 年更在圖像識別上獲得突破性的成功. 所以雖然深度學習理論很早便出現了, 但一直到 2002 年後數位時代來臨, 不論硬體計算效能還是資料產出都出現了噴發式的躍進 (算力 + 大數據), 才使得深度學習取得實用上的傲人成果. 
  5. 最後老師提到, 為何類神經網路是朝深度 (多層) 發展, 而不是朝變胖 (單層多神經元) 發展? 這是因為變胖的網路其實還是單層的線性網路, 無法模擬複雜的非線性函數, 而深度網路則可以 (universality theorem).


此單元談深度學習之應用, 摘要如下 :
  • 深度學習目的就是求取輸入 X 映射到輸出 Y 的函數 f: X -> Y
    其中 X 為輸入端 (input domain), 可以是字 (word), 字序列 (word sequence), 聲音 (audio signal), 點擊紀錄 (click log) 等.
    Y 為輸出端 (output domain). 可以是單一標籤 (single label), 串列標記 (sequence tags), 樹狀結構 (tree structure), 或機率分布 (probability distribution) 等. 
  • 輸入端的類型左右了選擇哪一種網路架構 (network architecture) 來聚合輸入資訊 (aggregate information) : Network architecture should consider the input properties. 例如 CNN 適合用來處理圖像, 而 RNN 則適合用來處理有時間順序 (temporal) 的資料. 
  • 輸出端的類型最常見的是分類 (classification) 任務, 例如情感分析 (sentiment analysis) 中的正負評, 語音辨識中的音素辨識 (phoneme recognition), 或圖像辨識中的手寫數字辨識等. 還有一種輸出類型是序列預測 (sequence prediction), 例如詞類序列標記 (POS sequence), 輸入一個句子要標記出每個詞彙的詞類, 還有語音辨識與機器翻譯都屬此類. 所以深度學習的任務取決於輸出端的類型是甚麼 (Learning tasks are decided by the output domain). 
  • 總之, 在設計深度學習網路時需綜合考量輸入與輸出端的特性 : Network design should leverage input and output domain properties.
  • 使用深度學習之核心要件 :
    (1). 大數據 (big data)
    (2). 運算力 (GPU)
    (3). 能耐 (talent, 即豐富的經驗) 
嗯, 上完第一課讓我對深度學習概念更清晰了. 

Python 學習筆記 : 內建函式 round() 是四捨五入還是五捨六入?

今天在讀 "Python 入門-邁向高手之路 (深智, 2018)" 時看到 round() 函式的範例, 作者將此函式的功能稱為五捨六入, 我一直認為 round() 是四捨五入, 但其實有時候是四捨五入, 有時候又是五捨六入, 如果在數值計算上有此誤解, 可能會積小差異變成大差異而得到錯誤的結果, 例如 : 

>>> round(0.4)        # 4 捨
0
>>> round(0.5)        # 5 捨
0
>>> round(0.6)        # 6 入
1

由此例可見 round() 確實不是四捨五入, 但下面範例卻打臉五捨六入的說法 : 

>>> round(0.47)     # 4 捨  
0
>>> round(0.57)     # 5入
1
>>> round(0.67)     # 6 入
1

此例顯示有些時候是四捨五入, 有些時候是五捨六入, 到底是甚麼原因呢? 其實這是因為電腦是二進制數值系統, 它可以精確地儲存整數, 但無法精確地儲存浮點數, 它儲存的其實只是近似值而已, 就是這個近似值的誤差使得 round() 有時四捨五入, 有時五捨六入的原因, 參考 :


用 print() 格式化字串來輸出變數實際儲存在記憶體中的數值即可明白這小小的誤差 : 

>>> print('%.50d' % 12345)       # 整數可精確地在二進位系統中儲存
00000000000000000000000000000000000000000000012345
>>> print('%.50f' % 0.4)             # 浮點數無法精確地在二進位系統中儲存
0.40000000000000002220446049250313080847263336181641
>>> print('%.50f' % 0.5)    
0.50000000000000000000000000000000000000000000000000
>>> print('%.50f' % 0.6)       
0.59999999999999997779553950749686919152736663818359
>>> print('%.50f' % 0.47)      
0.46999999999999997335464740899624302983283996582031
>>> print('%.50f' % 0.57)      
0.56999999999999995115018691649311222136020660400391
>>> print('%.50f' % 0.67)     

可見在二進制系統中, 浮點數儲存在記憶體中並非那麼精確, 與我們所認為的值有些許誤差, 不像整數可精確地儲存. 關於 print() 格式化字串參考 : 


Python 3 的內建函式 round() 可以傳入第二參數指定精確度, 語法如下 :

round( x [, n] ) 

其中備選參數 n 用來指定傳回值的小數位數. 

例如 : 

>>> round(3.15, 1)     # 五捨六入
3.1
>>> round(3.16, 1)     # 五捨六入
3.2
>>> round(4.14, 1)     # 四捨五入 (接近 4.1)
4.1
>>> round(4.15, 1)     # 四捨五入 
4.2
>>> round(4.16, 1)     # 四捨五入
4.2
>>> round(3.775, 2)   # 五捨六入
3.77
>>> round(3.776, 2)   # 五捨六入
3.78

可見 round() 有時四捨五入, 有時五捨六入, 下面這篇文章說其實是有規律的 :


其規則如下 : 
  1. 如果沒有傳入第二參數指定小數位數 (即傳回整數), 則 round() 會傳回最接近的整數.
  2. 如果有傳入第二參數指定小數位數, 則根據第二參數位數的奇偶性來決定是要入還是捨, 若第二參數位數為偶數則捨, 第二參數位數為偶數則入. 
第一項是說若未傳入第二參數 n 則 round(x) 會傳回最靠近 x 的整數, 但所謂 "最靠近" 卻沒提遇到 5 是捨是入的規則, 例如 : 

>>> round(0.4)       # 四捨
0
>>> round(0.5)       # 五捨
0
>>> round(0.50)     # 五捨
0
>>> round(0.51)     # 五入
1
>>> round(0.501)   # 五入
1
>>> round(1.4)       # 四捨
1
>>> round(1.5)       # 五入
2
>>> round(123.5)    # 五捨
124

可見小數後一位是 5 時到底要不要進位無法預測. 至於有傳入第二參數時要依據該位數的奇偶來判定是否進位採取奇捨偶入, 但下面卻是反例 :

>>> round(3.15, 1)        # 1 是奇數要捨 : 猜對
3.1
>>> round(3.25, 1)        # 2 是偶數要入 : 正確
3.2
>>> round(3.35, 1)        # 3 是奇數要捨 : 猜錯
3.4
>>> round(3.45, 1)        # 4 是偶數要入 : 正確
3.5

所以該篇所說的規則其實不完備. 與其猜 round() 是四捨五入還是五捨六入, 不如問要如何得到數學上的四捨五入更重要. 其實指定四捨五入位數的情形可用 Numpy 的 round() 來解決, 例如 : 

>>> import numpy as np     
>>> round(2.675, 2)             
2.67   
>>> np.round(2.675, 2)    
2.68
>>> np.round(3.35, 1)    
3.4
>>> np.round(4.15, 1)   
4.2
>>> np.round(3.775, 2)   
3.78

可見 Numpy 對於指定位數都符合四捨五入規則, 但要注意的是 np.round() 傳回的是 Numpy 的 float 型態, 可以用 float() 將其轉回 Python 原生的 float 型態 :

>>> type(np.round(4.15, 1))     
<class 'numpy.float64'>   
>>> float(np.round(4.15, 1))     
4.2

但若呼叫 np.round() 時不指定位數的話四捨五入就不靈了, 例如 : 

>>> np.round(0.5)            
0.0
>>> int(np.round(0.5))     
0
>>> np.round(0.501)  
1.0
>>> np.round(0.5000001)     
1.0
>>> np.round(0.6)   
1.0
>>> int(np.round(0.6))   
1

可見若小數點後只有 5 會被捨去, 但若比 5 多一點點就會進位了. 

參考 : 


2022-02-18 補充 :

我剛剛在下面這篇文章中找到 Numpy 沒有正確進行四捨五入的範例 :


最上面編號 107 的回應裡使用 655.665 取小數兩位, 四捨五入應該是 655.67 才對, 但 Numpy 卻傳回 655.66, 捨去沒有進位 : 

>>> np.round(655.665, 2)       
655.66

看來 Numpy 似乎也不太牢靠. 

不過編號 36 的回應卻給出期望的 655.67, 它使用 decimal.Decimal 類別搭配 ROUND_UP 常數來做, 所以首先要從內建模組 decimal 中匯入這兩個 : 

>>> from decimal import Decimal, ROUND_UP     
>>> Decimal(str(655.665)).quantize(Decimal('.01'), rounding=ROUND_UP)     
Decimal('655.67')

可見傳回值是一個 Decimal 物件, 可用 float() 轉成浮點數物件 : 

>>> float(Decimal(str(655.665)).quantize(Decimal('.01'), rounding=ROUND_UP))    
655.67

上面的範例改用這方法都正確輸出四捨五入結果, 例如 :

>>> float(Decimal(str(2.675)).quantize(Decimal('.01'), rounding=ROUND_UP))
2.68
>>> float(Decimal(str(3.35)).quantize(Decimal('.1'), rounding=ROUND_UP))    
3.4
>>> float(Decimal(str(4.15)).quantize(Decimal('.1'), rounding=ROUND_UP))
4.2
>>> float(Decimal(str(4.775)).quantize(Decimal('.01'), rounding=ROUND_UP))
4.78

2022年2月17日 星期四

momo 買書三本 (機器學習 & H 模型)

向母校圖書館借的 "最踏實AI之路:全白話機器學習一次搞懂" 最近被預約須還, 我只看完前兩章, 作者把 ML 觀念透過穿插的對話講得淺顯易懂, 覺得此書值得擁有, 毋須等下次預約, 剛好 momo 到 2/22 前有宅家樂讀活動 (滿額打 66 折), 所以就在 momo 買了 (加購另兩本) : 


原價共 1440 元, 打 66 折後 958 元, 抵用 momo 幣 64 元實付 894 元, 約打 62 折, 好划算!

本來打算還要買下面這本語音辨識, 但我查詢市圖有書可借, 故臨時取消 : 


參考 : 


2022年2月16日 星期三

市圖還書 3 本

 今天去市圖還書三本 :
都是二哥上學期幫他借的, 只留尚未看完的 No.1 先還再借, 其他兩本都先還了 (No.2 很值得參考, 等我有空回來玩 GAL/PAL 時再回借).