顯示具有 大數據 標籤的文章。 顯示所有文章

2019年1月22日 星期二

MongoDB 學習筆記 (二) : 樹莓派安裝 MongoDB

在 Win10 順利安裝了 MongoDB 後, 我想在樹莓派上也安裝看看, 雖然我比較偏向於 Redis, 但兩個 NoSQL 架構不同, 都玩玩看唄.

我參考 "不一樣的 Node.js (第二版)" 這本書的 7.3.1 節以下列指令進行安裝 :

sudo apt-get install mongodb

Debian GNU/Linux comes with ABSOLUTELY NO WARRANTY, to the extent
permitted by applicable law.
Last login: Mon Dec 31 08:22:50 2018 from 192.168.2.109
pi@raspberrypi:~ $ sudo apt-get install mongodb 
Reading package lists... Done
Building dependency tree
Reading state information... Done
The following extra packages will be installed:
  libboost-dev libboost1.55-dev libpcap0.8 mongodb-clients mongodb-dev
  mongodb-server
Suggested packages:
  libboost-doc libboost1.55-doc libboost-atomic1.55-dev
  libboost-chrono1.55-dev libboost-context1.55-dev libboost-coroutine1.55-dev
  libboost-date-time1.55-dev libboost-exception1.55-dev
  libboost-filesystem1.55-dev libboost-graph1.55-dev
  libboost-graph-parallel1.55-dev libboost-iostreams1.55-dev
  libboost-locale1.55-dev libboost-log1.55-dev libboost-math1.55-dev
  libboost-mpi1.55-dev libboost-mpi-python1.55-dev
  libboost-program-options1.55-dev libboost-python1.55-dev
  libboost-random1.55-dev libboost-regex1.55-dev
  libboost-serialization1.55-dev libboost-signals1.55-dev
  libboost-system1.55-dev libboost-test1.55-dev libboost-thread1.55-dev
  libboost-timer1.55-dev libboost-wave1.55-dev libboost1.55-tools-dev
  libmpfrc++-dev libntl-dev
The following NEW packages will be installed:
  libboost-dev libboost1.55-dev libpcap0.8 mongodb mongodb-clients mongodb-dev
  mongodb-server
0 upgraded, 7 newly installed, 0 to remove and 214 not upgraded.
Need to get 20.4 MB of archives.
After this operation, 207 MB of additional disk space will be used.
Do you want to continue? [Y/n] Y
Get:1 http://mirrordirector.raspbian.org/raspbian/ jessie/main libpcap0.8 armhf 1.6.2-2 [121 kB]
Get:2 http://mirrordirector.raspbian.org/raspbian/ jessie/main libboost1.55-dev armhf 1.55.0+dfsg-3 [5,809 kB]
Get:3 http://mirrordirector.raspbian.org/raspbian/ jessie/main libboost-dev armhf 1.55.0.2 [3,378 B]
Get:4 http://mirrordirector.raspbian.org/raspbian/ jessie/main mongodb-dev armhf 1:2.4.10-5+deb8u1 [1,073 kB]
Get:5 http://mirrordirector.raspbian.org/raspbian/ jessie/main mongodb-clients armhf 1:2.4.10-5+deb8u1 [10.1 MB]
Get:6 http://mirrordirector.raspbian.org/raspbian/ jessie/main mongodb-server armhf 1:2.4.10-5+deb8u1 [3,245 kB]
Get:7 http://mirrordirector.raspbian.org/raspbian/ jessie/main mongodb armhf 1:2.4.10-5+deb8u1 [12.2 kB]
Fetched 20.4 MB in 54s (374 kB/s)
Selecting previously unselected package libpcap0.8:armhf.
(Reading database ... 123977 files and directories currently installed.)
Preparing to unpack .../libpcap0.8_1.6.2-2_armhf.deb ...
Unpacking libpcap0.8:armhf (1.6.2-2) ...
Selecting previously unselected package libboost1.55-dev:armhf.
Preparing to unpack .../libboost1.55-dev_1.55.0+dfsg-3_armhf.deb ...
Unpacking libboost1.55-dev:armhf (1.55.0+dfsg-3) ...
Selecting previously unselected package libboost-dev:armhf.
Preparing to unpack .../libboost-dev_1.55.0.2_armhf.deb ...
Unpacking libboost-dev:armhf (1.55.0.2) ...
Selecting previously unselected package mongodb-dev.
Preparing to unpack .../mongodb-dev_1%3a2.4.10-5+deb8u1_armhf.deb ...
Unpacking mongodb-dev (1:2.4.10-5+deb8u1) ...
Selecting previously unselected package mongodb-clients.
Preparing to unpack .../mongodb-clients_1%3a2.4.10-5+deb8u1_armhf.deb ...
Unpacking mongodb-clients (1:2.4.10-5+deb8u1) ...
Selecting previously unselected package mongodb-server.
Preparing to unpack .../mongodb-server_1%3a2.4.10-5+deb8u1_armhf.deb ...
Unpacking mongodb-server (1:2.4.10-5+deb8u1) ...
Selecting previously unselected package mongodb.
Preparing to unpack .../mongodb_1%3a2.4.10-5+deb8u1_armhf.deb ...
Unpacking mongodb (1:2.4.10-5+deb8u1) ...
Processing triggers for man-db (2.7.0.2-5) ...
Processing triggers for systemd (215-17+deb8u6) ...
Setting up libpcap0.8:armhf (1.6.2-2) ...
Setting up libboost1.55-dev:armhf (1.55.0+dfsg-3) ...
Setting up libboost-dev:armhf (1.55.0.2) ...
Setting up mongodb-dev (1:2.4.10-5+deb8u1) ...
Setting up mongodb-clients (1:2.4.10-5+deb8u1) ...
Setting up mongodb-server (1:2.4.10-5+deb8u1) ...
Adding system user `mongodb' (UID 113) ...
Adding new user `mongodb' (UID 113) with group `nogroup' ...
Not creating home directory `/home/mongodb'.
Adding group `mongodb' (GID 121) ...
Done.
Adding user `mongodb' to group `mongodb' ...
Adding user mongodb to group mongodb
Done.
Setting up mongodb (1:2.4.10-5+deb8u1) ...
Processing triggers for libc-bin (2.19-18+deb8u7) ...
Processing triggers for systemd (215-17+deb8u6) ...

可見相依套件還真不少, 總共需要 207MB, 比 Win10 還少.

查詢是否已有 mongodb 使用者 :

pi@raspberrypi:~ $ grep mongodb /etc/passwd 
mongodb:x:113:65534::/home/mongodb:/bin/false 


# 在Raspberry Pi 2代和3代(Jessie版Raspbian系統)安裝MongoDB 3.0.9
# 樹莓派 Raspberry Pi 安裝 Node.js 與 MongoDB 資料庫
# Web Development With Node And Express

2018年9月7日 星期五

買書 : Python 大數據特訓班

晚上去河堤還書回途經過明儀去取書, 因昨日在博客來看到這本 "Python 大數據特訓班 (碁峰, 鄧文淵)", 被裡面介紹的 Line 訊息傳送吸引, 請明儀幫我找書 :


此外, 書中還介紹了擷取台股數據的 twstock 模組用法, 以前我都用 PHP 來做, 現在用此模組更方便! 尋尋覓覓終於有人指路, 省去不少功夫. 所以說, 不只常逛圖書館可挖到寶, 常逛書局也是如此, 人家花了一年將經驗寫成書, 我只花了幾兩銀子便垂手而得, 這麼便宜的交易許多人卻不識得, 委實萬分可惜.

寶書買來只要下點功夫勤練, 吸星大法神功不久即可練成, 這些在外面補習班動輒數千上萬, 但不論聽多少課, 還是得動手實作才能將神功吸過來, 同樣都要花時間, 買書自戀只要花數百元即可.

2018年4月20日 星期五

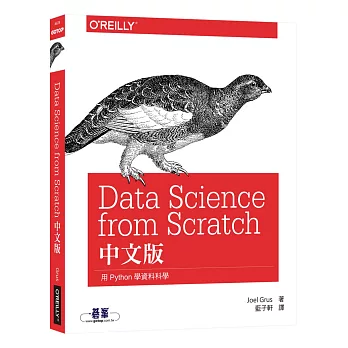
好書 : Data Science from Scratch-用 Python 學資料科學

跟市圖預約這本書好久了 (約半年), 最近才拿到書, 看書名有 from scratch 原以為是寫給初學者看, 手把手從零開始講的入門書, 看了前兩章發覺此書寫得簡約不囉嗦, 換句話說就是內容壓得很踏實, 並不是可以輕鬆閱讀的書, 畢竟 25 章的內容要用 309 頁篇幅來鋪陳, 沒有省話一哥的本事是寫不出來的. 此書翻譯者藍子軒譯筆流暢, 之前買過幾本他翻的書, 評價都不錯.


Source : 博客來


此書感覺有點像資料科學概論, 幾乎每一個主題都有觸及, 例如 4~7 章介紹資料科學要用到的線性代數, 機率, 與統計學, 第 9 章提到網頁擷取等, 但沒有辦法每一個都深入介紹, 所以每章尾巴都有一節 "進一步探索" 介紹該章提及但無法納入的內容之參考資料.


2018年2月3日 星期六

好書 : Python Machine Learning Blueprints

今天在博客來看到一本簡體 ML 的好書, 可惜目前已賣完 :

# Python機器學習實踐指南 (博客來 87 折 $360)

不過天瓏書店有售, 打 95 折 :

# Python 機器學習實踐指南 (Python Machine Learning Blueprints) (天瓏 95 折 $393)


此書其實是下面這本 Packt 原文書的簡體版 :

# Python Machine Learning Blueprints: Intuitive data projects you can relate to

從此書目錄看, 內容係實用導向, 特別是與金融或理財相關課題, 例如預測股票市場, 預測 IPO 股票走勢, 尋找低價機票或公寓, 建構推薦引擎與聊天機器人, ... 等等, 真是非常吸引人. 書中範例原始碼可在 Github 下載 : 

# https://github.com/PacktPublishing/Python-Machine-Learning-Blueprints

博客來還有另外一本不錯的 ML 簡體書 (強國人著作, 不是譯本) :

# 機器學習:Python實踐 $354

參考 :

# Machine learning resources

2017年12月28日 星期四

R 語言學習筆記 (三) : 陣列

測完矩陣接著測試陣列, 此前的測試紀錄如下 :

# R 語言安裝
# 在樹莓派上安裝 R 語言
# R 語言學習筆記 (一) : 基本語法與向量
# R 語言學習筆記 (二) : 矩陣

R 語言的陣列是矩陣的維度擴展 (矩陣是陣列的一個特例, 它是二維的陣列), 因此其元素一樣也都是同質的 (即資料類型必須相同). 陣列也可視為多維度的向量 (注意, R 語言中向量並無維度), 使用多個索引如 A[i, j, k, ...] 來存取元素, 其中索引 i, j, k, ... 代表各維之位置. 最常用的是三維陣列, 在一些時間序列的應用中甚至會用到高維陣列.

與幾何類比, 向量相當於線; 矩陣相當於面; 而陣列則相當於多維空間. 不管是向量, 矩陣或陣列, 它們的元素都必須同質, 即由相同類型的資料組成.


一. 建立陣列的方法 :

1. 呼叫 array() 函數 : 

函數 array() API 如下 :

array(data=NA, dim=length(data), dimnames=NULL)

data : 向量或串列 (用來填滿陣列), 向量以外的資料會自動被 as.vector() 強制轉型.
dim : 整數向量, 用來依序定義各維度之長度.
dimnames : 字串列表 (list) 用來賦予各維度因次名稱 (例如列名, 行名, 表名)

三維陣列的第一列相當於矩陣之列, 第二維相當於行, 第三維通常稱為表 (table).  例如以下的三維陣列用 1:24 的向量來填滿 3*4*2 個元素位置, 會逐行 (by column) 填入元素, 即先填滿第一行, 再填第二行 :

> A <- array(1:24, c(3,4,2))    #建立一,二,三維長度各為 3,4,2 之陣列
> A
, , 1                          #顯示第三維第一個資料結構 (相當於 table 1)

     [,1] [,2] [,3] [,4]
[1,]    1    4    7   10
[2,]    2    5    8   11
[3,]    3    6    9   12

, , 2                          #顯示第三維第二個資料結構 (相當於 table 2)

     [,1] [,2] [,3] [,4]
[1,]   13   16   19   22
[2,]   14   17   20   23
[3,]   15   18   21   24

接著來看看陣列的資料結構是用甚麼組成的 :

> class(A)          #檢查資料結構是 array
[1] "array"
> is.array(A)
[1] TRUE
> is.vector(A)    #不是向量結構
[1] FALSE
> is.matrix(A)    #不是矩陣結構
[1] FALSE
> is.array(A[, 1 ,])   # A[ , 1, ] 是二維陣列  (降維)
[1] TRUE
> is.matrix(A[, 1, ])     # A[, 1, ] 也是矩陣 (降維)
[1] TRUE
> class(A[,1,])    # A[, 1, ] 的真實結構是矩陣
[1] "matrix"
> A[,1,]             
     [,1] [,2]
[1,]    1   13
[2,]    2   14
[3,]    3   15
> A[1,1,]     
[1]  1 13
> is.matrix(A[1,1,])      #A[1, 1, ] 則降維成向量
[1] FALSE
> is.vector(A[1,1,])
[1] TRUE

上面降維後的 A[ , 1, ] 用 is.array() 與 is.matrix() 檢查, 結果它似乎既是陣列 (二維) 也是矩陣, 用 class() 去檢驗即知事實上 A[ , 1, ] 結構是矩陣而非陣列, 可見陣列確實是用矩陣堆起來的, 而矩陣又是用向量堆起來的.

其實 R 語言中的二維陣列就是矩陣, 例如用 array() 建立一個二維陣列, 用 is.array() 與 is.matrix() 都回應 TRUE, 表示它既是陣列也是矩陣, 但用 class() 去檢查其結構類型卻歸類為是矩陣 :

> A <- array(1:12, c(4,3))     #建立一個二維陣列
> A
     [,1] [,2] [,3]
[1,]    1    5    9
[2,]    2    6   10
[3,]    3    7   11
[4,]    4    8   12
> is.array(A)       #用 array() 建立當然是陣列
[1] TRUE
> is.matrix(A)     #也是矩陣
[1] TRUE
> class(A)           #結構上歸類為矩陣
[1] "matrix"

如果建立一個矩陣之後用 as.array() 強制轉成陣列會怎樣呢?

> A <- matrix(1:12, nrow=4)    #建立一個矩陣
> A
     [,1] [,2] [,3]
[1,]    1    5    9
[2,]    2    6   10
[3,]    3    7   11
[4,]    4    8   12
> is.matrix(A)     #用 matrix() 建立當然是矩陣
[1] TRUE
> is.array(A)       #嘿! A 竟然也是陣列
[1] TRUE
> class(A)           #結構是矩陣
[1] "matrix"
> B <- as.array(A)      #用 as.array() 將 A 強制轉型為陣列 B
> B
     [,1] [,2] [,3]
[1,]    1    5    9
[2,]    2    6   10
[3,]    3    7   11
[4,]    4    8   12
> is.matrix(B)     #還是矩陣
[1] TRUE
> is.array(B)       #當然是陣列
[1] TRUE
> class(B)           #結構仍歸類為矩陣
[1] "matrix"

我們可以用 identical() 函數來檢驗用 matrix() 與 array() 建立的二維物件是否雷同 :

> A <- matrix(1:12, nrow=4)    #建立一個矩陣 A
> A
     [,1] [,2] [,3]
[1,]    1    5    9
[2,]    2    6   10
[3,]    3    7   11
[4,]    4    8   12
> B <- array(1:12, c(4,3))         #建立一個二維陣列 B, 內容與 A 矩陣相同
> B
     [,1] [,2] [,3]
[1,]    1    5    9
[2,]    2    6   10
[3,]    3    7   11
[4,]    4    8   12
> class(A)         #矩陣 A 結構為 matrix
[1] "matrix"
> class(B)         #陣列 B 結構亦為 matrix
[1] "matrix"
> identical(A, B)    #呼叫 identical() 顯示兩者是同樣物件
[1] TRUE

總之, 在 R 語言中, 大於二維的資料結構是陣列, 二維陣列就被歸類為矩陣.

如果傳入的向量不夠填滿陣列, 則會套用循環規則從頭抓資料, 例如 :

> array(1:17, c(3,4,2))
, , 1

     [,1] [,2] [,3] [,4]
[1,]    1    4    7   10
[2,]    2    5    8   11
[3,]    3    6    9   12

, , 2

     [,1] [,2] [,3] [,4]
[1,]   13   16    2    5
[2,]   14   17    3    6
[3,]   15    1    4    7

下面是用這 24 個元素來建立一個四維陣列 :

> A <- array(1:24, c(3,2,2,2))
> A
, , 1, 1

     [,1] [,2]
[1,]    1    4
[2,]    2    5
[3,]    3    6

, , 2, 1

     [,1] [,2]
[1,]    7   10
[2,]    8   11
[3,]    9   12

, , 1, 2

     [,1] [,2]
[1,]   13   16
[2,]   14   17
[3,]   15   18

, , 2, 2

     [,1] [,2]
[1,]   19   22
[2,]   20   23
[3,]   21   24

五維陣列範例如下 :

> A <- array(1:32, c(2,2,2,2,2))
> A
, , 1, 1, 1

     [,1] [,2]
[1,]    1    3
[2,]    2    4

, , 2, 1, 1

     [,1] [,2]
[1,]    5    7
[2,]    6    8

, , 1, 2, 1

     [,1] [,2]
[1,]    9   11
[2,]   10   12

, , 2, 2, 1

     [,1] [,2]
[1,]   13   15
[2,]   14   16

, , 1, 1, 2

     [,1] [,2]
[1,]   17   19
[2,]   18   20

, , 2, 1, 2

     [,1] [,2]
[1,]   21   23
[2,]   22   24

, , 1, 2, 2

     [,1] [,2]
[1,]   25   27
[2,]   26   28

, , 2, 2, 2

     [,1] [,2]
[1,]   29   31
[2,]   30   32

可見 R 語言在顯示高維陣列內容時, 是把它拆解到矩陣 (就是第一與第二維組成的二維陣列) 當作最小的單位, 然後從第三維起依序顯示 "每一張表".

2. 呼叫 dim() 函數設定維度將向量或列表變成陣列 :   

R 語言中向量 (vector) 是一群有序資料, 看起來像是一維, 但在 R 裡面是沒有維度的資料結構, 用 dim() 檢查會得到 NULL. 與建立矩陣一樣, 若呼叫 dim() 為向量指定大於 2 的維度, 則此無維度的向量將變成有維度的陣列結構, 例如 :

> v <- 1:24                 #建立 24 個元素的向量
> dim(v)                         #向量是無維度的資料結構 (NULL)
NULL 
> dim(v) <- c(4,3,2)   #指定維度給向量會使其變成矩陣 (2 維) 或向量 (大於 2 維)
> v
, , 1

     [,1] [,2] [,3]
[1,]    1    5    9
[2,]    2    6   10
[3,]    3    7   11
[4,]    4    8   12

, , 2

     [,1] [,2] [,3]
[1,]   13   17   21
[2,]   14   18   22
[3,]   15   19   23
[4,]   16   20   24

> class(v)                       #變成陣列了
[1] "array"

> dim(v)                         #查詢陣列維度是 4*3*2
[1] 4 3 2


二. 存取陣列元素 :

存取陣列元素的方式與矩陣一樣, 也是用索引, 只是索引比較多而已.

> A <- array(1:24, c(4,3,2))
> A
, , 1

     [,1] [,2] [,3]
[1,]    1    5    9
[2,]    2    6   10
[3,]    3    7   11
[4,]    4    8   12

, , 2

     [,1] [,2] [,3]
[1,]   13   17   21
[2,]   14   18   22
[3,]   15   19   23
[4,]   16   20   24

> A[1,1,1]
[1] 1
> A[1,3,1]
[1] 9
> A[1,3,2]
[1] 21
> A[1,1,]
[1]  1 13

> A[1,,]
     [,1] [,2]
[1,]    1   13
[2,]    5   17
[3,]    9   21

> A[,1,]
     [,1] [,2]
[1,]    1   13
[2,]    2   14
[3,]    3   15
[4,]    4   16

> A[,,1]
     [,1] [,2] [,3]
[1,]    1    5    9
[2,]    2    6   10
[3,]    3    7   11
[4,]    4    8   12

注意, 這些取出來的物件都降階變成了二維的矩陣了, 可用 class() 檢驗. 如果取出來的元件想保留 array 架構, 不要降階成矩陣, 可以在索引最後面加上 drop=FALSE (預設是 TRUE), 例如 :

 > A <- array(1:24, c(4,3,2))
> A[1,,]               #只取第一維
     [,1] [,2]
[1,]    1   13
[2,]    5   17
[3,]    9   21
> class(A[1,,])     #降階為 matrix
[1] "matrix" 
> A[1,,,drop=FALSE]    #不降階 (保留陣列結構)
, , 1

     [,1] [,2] [,3]
[1,]    1    5    9

, , 2

     [,1] [,2] [,3]
[1,]   13   17   21

> class(A[1,,,drop=FALSE])    #仍為 array 結構
[1] "array"

> identical(A[1,,], A[1,,,drop=FALSE])  #兩個是不同物件 (內容相同, 但結構不同)
[1] FALSE 

上面是存取三維陣列內容時的降維情形, 如果取得的內容是二維, 則降階為矩陣; 若小於二維則為向量. 從多維陣列取得的內容如果大於二維, 則仍然是陣列結構, 例如 :

> A <- array(1:32, c(2,2,2,2,2))
> A
, , 1, 1, 1

     [,1] [,2]
[1,]    1    3
[2,]    2    4

, , 2, 1, 1

     [,1] [,2]
[1,]    5    7
[2,]    6    8

, , 1, 2, 1

     [,1] [,2]
[1,]    9   11
[2,]   10   12

, , 2, 2, 1

     [,1] [,2]
[1,]   13   15
[2,]   14   16

, , 1, 1, 2

     [,1] [,2]
[1,]   17   19
[2,]   18   20

, , 2, 1, 2

     [,1] [,2]
[1,]   21   23
[2,]   22   24

, , 1, 2, 2

     [,1] [,2]
[1,]   25   27
[2,]   26   28

, , 2, 2, 2

     [,1] [,2]
[1,]   29   31
[2,]   30   32

> A[,,,1,1]     #取得子陣列
, , 1

     [,1] [,2]
[1,]    1    3
[2,]    2    4

, , 2

     [,1] [,2]
[1,]    5    7
[2,]    6    8

> class(A[,,,1,1])   #結構是陣列 (因為是三維)
[1] "array"

取得陣列內容時也可以使用負索引來排除不要的部分, 例如 :

> A <- array(1:24, c(4,3,2))
> A
, , 1

     [,1] [,2] [,3]
[1,]    1    5    9
[2,]    2    6   10
[3,]    3    7   11
[4,]    4    8   12

, , 2

     [,1] [,2] [,3]
[1,]   13   17   21
[2,]   14   18   22
[3,]   15   19   23
[4,]   16   20   24

> A[-3, c(1,3), 2]     #第一維不要第三列, 第二維取第一與第三行, 第三維取第二張
     [,1] [,2]
[1,]   13   21
[2,]   14   22
[3,]   16   24

修改陣列的內容只要直接將向量或矩陣指派給陣列的指定部分即可, 例如 :

> A <- array(1:24, c(4,3,2))   #建立陣列
> A
, , 1

     [,1] [,2] [,3]
[1,]    1    5    9
[2,]    2    6   10
[3,]    3    7   11
[4,]    4    8   12

, , 2

     [,1] [,2] [,3]
[1,]   13   17   21
[2,]   14   18   22
[3,]   15   19   23
[4,]   16   20   24

> A[3:4,c(1,3),1]    #第一維之 3~4 列, 第二維的 1 與 3 行, 第三維的第一張表
     [,1] [,2]
[1,]    3   11
[2,]    4   12
> A[3:4,c(1,3),1] <- matrix(NA, nrow=2, ncol=2)   #將矩陣指派給陣列局部
> A
, , 1

     [,1] [,2] [,3]
[1,]    1    5    9
[2,]    2    6   10
[3,]   NA    7   NA
[4,]   NA    8   NA

, , 2

     [,1] [,2] [,3]
[1,]   13   17   21
[2,]   14   18   22
[3,]   15   19   23
[4,]   16   20   24


 三. 陣列常用函數 : 


 函數 說明
 array(data, dim, dimnames) 建立維度為 dim 向量之陣列
 str(x) 顯示物件結構與內容
 length(x) 顯示陣列元素個數
 dim(x) 顯示物件 (矩陣, 陣列, 資料框) 維度
 is.array(x) 檢查是否為鎮ㄌㄧ類型
 as.array(x) 將物件強制轉型為陣列陣類型
 identical(x, y) 檢查兩個物件 x, y 是否為相同物件


2017年12月24日 星期日

R 語言學習筆記 (二) : 矩陣

今天繼續測試 R 語言的進階資料結構中的矩陣 (matrix). 本系列之前的測試筆記參考 :

# R 語言安裝
# 在樹莓派上安裝 R 語言
# R 語言學習筆記 (一) : 基本語法與向量

在 R 語言中, 矩陣 (matrix) 是二維資料物件, 具有列 (row) 與行 (column) 兩個維度; 三維以上的資料結構則稱為陣列 (array), 因此矩陣其實是陣列的一種特例, 即矩陣是二維陣列 (但二維陣列卻不是矩陣).

矩陣的元素可以是 numeric, character, logical, complex, raw 或 NA 等型態資料; 不過因為矩陣通常用在數值運算, 因此其元素資料型別最常見的是數值 (numeric) 或複數 (complex) 型態. 矩陣運算是向量化運算, 亦即元素對元素的運算.


一. 建立矩陣物件 : 

建立矩陣有下列幾種方法 :

1. 呼叫 matrix() 函數 :

matrix(data=NA, nrow=1, ncol=1, byrow=FALSE, dimnames=NULL)

參數 :

data=資料向量或列表, 通常為 numeric 類型
nrow=列數
ncol=行數
byrow=逐列填入, 預設 FALSE 表示維逐行填入, 即第一行填完再填第二行
dimnames=列與行名稱字串向量組成的串列, 即 list(vrow, vcol)

其中前 3 個參數固定是 data, nrow, 與 ncol, 不須指名, 其餘則須指名. 例如 :

> matrix(1:12, 3, 4)    #建立 3列 * 4 行矩陣 (預設逐行填入)
     [,1] [,2] [,3] [,4]
[1,]    1    4    7   10
[2,]    2    5    8   11
[3,]    3    6    9   12

可見預設逐行填入是先走直的再走橫的. 若 byrow 設為 TRUE, 則先走橫的再走直的, 例如 :

> matrix(1:12, 3, 4, TRUE)    #建立 3列 * 4 行矩陣 (指定逐列填入)
     [,1] [,2] [,3] [,4]
[1,]    1    2    3    4
[2,]    5    6    7    8
[3,]    9   10   11   12

列數行數不必都指定, 只輸入列數即可, R 會自動計算行數, 例如 : 

> matrix(1:12, 3)         #只輸入列 (第二參數預設是列數)
     [,1] [,2] [,3] [,4]
[1,]    1    4    7   10
[2,]    2    5    8   11
[3,]    3    6    9   12

> matrix(1:12, 4)          #只輸入列 (第二參數預設是列數)
     [,1] [,2] [,3]
[1,]    1    5    9
[2,]    2    6   10
[3,]    3    7   11
[4,]    4    8   12

若要在第二參數單獨指定行數, 則須指明為 ncol :

> matrix(1:12, ncol=4)     #第二參數若非列數則須指明
     [,1] [,2] [,3] [,4]
[1,]    1    4    7   10
[2,]    2    5    8   11
[3,]    3    6    9   12

若未指定列數與行數, 則因 byrow 預設為 FALSE, 會建立一個 n*1 的單行矩陣 : 

> matrix(1:12)     #未指定列數與行數排成單行矩陣
      [,1]
 [1,]    1
 [2,]    2
 [3,]    3
 [4,]    4
 [5,]    5
 [6,]    6
 [7,]    7
 [8,]    8
 [9,]    9
[10,]   10
[11,]   11
[12,]   12

如果向量元素無規則可循必須逐一輸入, 例如 :

> matrix(c(5,12,7,0,1,3,6,14,2,8,11,9),4)
     [,1] [,2] [,3]
[1,]    5    1    2
[2,]   12    3    8
[3,]    7    6   11
[4,]    0   14    9

但是這樣輸入一長串資料可讀性不高, 可以用 byrow 方式輸入 :

> matrix(c(5,1,2,
+               12,3,8,
+               7,6,11,
+               0,14,9),4,byrow=TRUE)
     [,1] [,2] [,3]
[1,]    5    1    2
[2,]   12    3    8
[3,]    7    6   11
[4,]    0   14    9

這樣就可讀性就比較高了. 注意, 上面的三個加號 + 是按 Enter 鍵後 R 控制台自動顯示的, 表示指令尚未完全.

如果 data 參數傳入一個純量或 NA, 則 R 會套用循環規則自動複製該單一數值填充整個矩陣 :

> matrix(0,4,3)
     [,1] [,2] [,3]
[1,]    0    0    0
[2,]    0    0    0
[3,]    0    0    0
[4,]    0    0    0
> matrix(NA,4,3)
     [,1] [,2] [,3]
[1,]   NA   NA   NA
[2,]   NA   NA   NA
[3,]   NA   NA   NA
[4,]   NA   NA   NA

由上可知, 輸出矩陣時會在左方與上方標示矩陣列與行索引位置, 但矩陣可用 matrix() 的最後一個參數 dimnames 來設定列名與欄名, 其值為列與行名稱字串向量組成的串列 list(vrow, vcol), 例如 :

> matrix(1:12, 4, dimnames=list(c("R1","R2","R3","R4"),c("C1","C2","C3")))
   C1 C2 C3
R1  1  5  9
R2  2  6 10
R3  3  7 11
R4  4  8 12

可見索引標示已經改為列名與行名了. 除了在建立矩陣時就用 dimnames 參數設定外, 也可以在建立後呼叫 rownames() 與 colnames() 分別設定或修改列名與欄名 :

> m=matrix(1:12, 4)
> m
     [,1] [,2] [,3]
[1,]    1    5    9
[2,]    2    6   10
[3,]    3    7   11
[4,]    4    8   12

> rownames(m) <- c("R1","R2","R3","R4")   #設定列名
> m
   [,1] [,2] [,3]
R1    1    5    9
R2    2    6   10
R3    3    7   11
R4    4    8   12
> colnames(m) <- c("C1","C2","C3")   #設定行名
> m
   C1 C2 C3
R1  1  5  9
R2  2  6 10
R3  3  7 11
R4  4  8 12

或者用 dimnames() 函數一次設定或修改, 例如 :

> m=matrix(1:12, 4)
> m
     [,1] [,2] [,3]
[1,]    1    5    9
[2,]    2    6   10
[3,]    3    7   11
[4,]    4    8   12
> dimnames(m) <- list(c("R1","R2","R3","R4"),c("C1","C2","C3"))
> m
   C1 C2 C3
R1  1  5  9
R2  2  6 10
R3  3  7 11
R4  4  8 12
> dimnames(m)     #取得矩陣維度資訊與列行名稱
[[1]]
[1] "R1" "R2" "R3" "R4"

[[2]]
[1] "C1" "C2" "C3"


2. 呼叫 dim() 設定維度將向量或列表轉成矩陣 :

矩陣的因次或維度 (dimension, 即列數與行數) 可以呼叫 dim() 函數來查詢 :

> m=matrix(1:12, 3, 4)
> dim(v)     #查詢矩陣因次
[1] 3 4              # 3 列 4 行

回應的兩個數分別為列與行. 函數 dim(v) 除了做 getter 外, 也可以做 setter, 將一個代表列數與行數的向量 c(nrow, ncol) 設定給 dim(v) 可將向量 v 轉成矩陣; 例如 :

> v=c(5,12,7,0,1,3,6,14,2,8,11,9)
> v
 [1]  5 12  7  0  1  3  6 14  2  8 11  9
> class(v)
[1] "numeric"                   #數值型態的原型向量
> dim(v)                      #向量的維度是 NULL
NULL
> dim(v) <- c(4,3)       #設定向量的維度是 4*3
> v
     [,1] [,2] [,3]
[1,]    5    1    2
[2,]   12    3    8
[3,]    7    6   11
[4,]    0   14    9
> class(v)                     #向量設定維度後變成矩陣
[1] "matrix"
> dim(v)
[1] 4 3                               #矩陣維度 4*3

但是若將向量的維度指定為一個三元素以上的維度向量, 則會變成陣列型態, 例如 :

> v=c(5,12,7,0,1,3,6,14,2,8,11,9)
> dim(v) <- c(2,3,2)    #改成三個維度
> v
, , 1

     [,1] [,2] [,3]
[1,]    5    7    1
[2,]   12    0    3

, , 2

     [,1] [,2] [,3]
[1,]    6    2   11
[2,]   14    8    9
> class(v)      # 變成 array 類型
[1] "array" 

除了向量外, 列表也可以轉成矩陣, 同樣也是透過呼叫 dim() 設定列表的維度 :

> l=list(5,12,7,0,1,3,6,14,2,8,11,9)   
> class(l)
[1] "list"
> dim(l)=c(4,3)
> l
     [,1] [,2] [,3]
[1,] 5    1    2 
[2,] 12   3    8 
[3,] 7    6    11
[4,] 0    14   9 
> class(l)
[1] "matrix"


3. 呼叫 rbind() 或 cbind() 將列向量或行向量組合成矩陣 :

建立矩陣的第三種方法是利用 rbind() 或 cbind() 將向量組合成矩陣, rbind() 是將向量當成矩陣的列組合起來, 故這些向量即為列向量, 例如 :

> rbind(c(1,5,9),c(2,6,10),c(3,7,11),c(4,8,12))
     [,1] [,2] [,3]
[1,]    1    5    9
[2,]    2    6   10
[3,]    3    7   11
[4,]    4    8   12

也可以先建立列向量再組合, 這樣會把列向量變數名稱作為矩陣的列名稱, 例如 :

> R1 <- c(1,5,9)      #先建立列向量
> R2 <- c(2,6,10)
> R3 <- c(3,7,11)
> R4 <- c(4,8,12)
> rbind(R1,R2,R3,R4)
   [,1] [,2] [,3]
R1    1    5    9
R2    2    6   10
R3    3    7   11
R4    4    8   12

同樣地, 也可以用 cbind() 將行向量組成矩陣, 例如 :

> cbind(c(1,2,3,4),c(5,6,7,8),c(9,10,11,12))
     [,1] [,2] [,3]
[1,]    1    5    9     
[2,]    2    6   10
[3,]    3    7   11
[4,]    4    8   12

> C1 <- c(1,2,3,4)          #先建立行向量
> C2 <- c(5,6,7,8)
> C3 <- c(9,10,11,12)
> cbind(C1,C2,C3)
     C1 C2 C3
[1,]  1  5  9
[2,]  2  6 10
[3,]  3  7 11
[4,]  4  8 12

可見若先建立行向量再組合會把行向量變數名稱作為矩陣的行名稱.


4. 使用 diag() 建立對角矩陣 :

diag(x = 1, nrow=1, ncol)

參數如下 :

x=向量或矩陣
nrow=列數
ncol=行數

若 nrow=ncol 或只指定 nrow, 則 diag() 將建立一個以 x 為軸的對稱矩陣, 例如 :

> diag(1, nrow=5)                #ncol 不指定時等於 nrow
     [,1] [,2] [,3] [,4] [,5]
[1,]    1    0    0    0    0
[2,]    0    1    0    0    0
[3,]    0    0    1    0    0
[4,]    0    0    0    1    0
[5,]    0    0    0    0    1

上面這種主對角元素為 1, 其餘元素均為 0 之矩陣稱為單位矩陣 I (unitary matrix). 單位矩陣之特徵值為 1, 任何矩陣與單位矩陣之內積等於本身, 即 :

A %*% I=A
I %*% A=A

下面這個 1*5 矩陣看起來像向量, 實際上是矩陣 (結構不同).

> diag(1, ncol=5)                   #nrow 預設為 1, 故建立 1*5 矩陣
     [,1] [,2] [,3] [,4] [,5]
[1,]    1    0    0    0    0
> class(diag(1, ncol=5))
[1] "matrix"

不是方陣之對角矩陣 : 

> diag(1, nrow=5, ncol=3)   
     [,1] [,2] [,3]
[1,]    1    0    0
[2,]    0    1    0
[3,]    0    0    1
[4,]    0    0    0
[5,]    0    0    0
> diag(1, nrow=3, ncol=5)
     [,1] [,2] [,3] [,4] [,5]
[1,]    1    0    0    0    0
[2,]    0    1    0    0    0
[3,]    0    0    1    0    0

diag() 函數第一參數傳入向量時會套用璇還規則 :

> diag(c(1,2), nrow=5)             #x=向量時套用循環規則在對稱軸上
     [,1] [,2] [,3] [,4] [,5]
[1,]    1    0    0    0    0
[2,]    0    2    0    0    0
[3,]    0    0    1    0    0
[4,]    0    0    0    2    0
[5,]    0    0    0    0    1
> diag(1:6, nrow=5)
     [,1] [,2] [,3] [,4] [,5]
[1,]    1    0    0    0    0
[2,]    0    2    0    0    0
[3,]    0    0    3    0    0
[4,]    0    0    0    4    0
[5,]    0    0    0    0    5

diag() 函數第一參數也可以傳入矩陣, 它會傳回矩陣對角元素形成之向量, 例如 :

> A <- matrix(1:16, nrow=4)
> A
     [,1] [,2] [,3] [,4]
[1,]    1    5    9   13
[2,]    2    6   10   14
[3,]    3    7   11   15
[4,]    4    8   12   16
> v=diag(A)           #傳回對角元素
> v
[1]  1  6 11 16
> class(v)               #diag(A) 傳回向量
[1] "integer"
> is.vector(v)       
[1] TRUE


二. 存取矩陣元素 : 

與存取向量類似, 存取矩陣也是使用中 (方) 括號, 但矩陣要用兩維 m[i, j], 第一索引 i 是列, 第二索引 j 是行. 例如 :

> m=matrix(1:12, 4,3)
> dimnames(m) <- list(c("R1","R2","R3","R4"),c("C1","C2","C3"))
> m
   C1 C2 C3
R1  1  5  9
R2  2  6 10
R3  3  7 11
R4  4  8 12
> m[2,2]    #取得第 2 列第 2 行元素
[1] 6
> m[2,]
C1 C2 C3
 2  6 10
> m[,2]      #取得第 2 行元素
R1 R2 R3 R4
 5  6  7  8
> m[2,c(2,3)]    #取得第 2 列第 2, 3 行元素
C2 C3
 6 10
> m[c(3,4),2]    #取得第 3, 4 列第 2 行元素
R3 R4
 7  8
> m[3:4,2]        #取得第 3~4 列第 2 行元素
R3 R4
 7  8

若取出之元素若維度小於 2 (例如某列或行中的幾個元素) 會降階為原型向量; 若維度等於 2 則仍為矩陣 (子矩陣). 從矩陣中取出元素時若要保留矩陣類型可在中括號內指定 drop=FALSE, 例如 :

> class(m[2,])   #取出的資料維度小於 1 變成向量
[1] "numeric"
> class(m[,2])   #取出的資料維度小於 1 變成向量
[1] "numeric"
> class(m[2:3,2:3])    #取出的資料維度等於 1 仍為矩陣
[1] "matrix" 
> (m[2, , drop=FALSE])
   C1 C2 C3
R2  2  6 10
> class(m[,2,drop=FALSE])     #取出元素時不降階, 仍為矩陣類型
[1] "matrix"
> (m[,2,drop=FALSE])
   C2
R1  5
R2  6
R3  7
R4  8
> class(m[2, , drop=FALSE])    #取出元素時不降階, 仍為矩陣類型
[1] "matrix"

存取矩陣元素可以使用負索引來排除不要的列或行, 負索引只是在查詢時排除特定元素而已, 原矩陣不受影響. 例如 :

> m[-2, -2]     #不要顯示第 2 列第 2 行元素
   C1 C3
R1  1  9
R3  3 11
R4  4 12
> m                 # 原矩陣不受影響
   C1 C2 C3
R1  1  5  9
R2  2  6 10
R3  3  7 11
R4  4  8 12
> m[-c(2,3), -2]     #不要顯示第 2, 3 列第 2 行元素
   C1 C3
R1  1  9
R4  4 12
> m[-c(2:3), -2]     #不要顯示第 2~3 列第 2 行元素
   C1 C3
R1  1  9
R4  4 12

修改矩陣元素之值只要用設定運算子將向量指派給矩陣元素即可, 例如 :

> m[2:3, ] <- 99     #第 2~3 列改為 99
> m
   C1 C2 C3
R1  1  5  9
R2 99 99 99
R3 99 99 99 
R4  4  8 12
> m[1,] <- NA        #第 1 列改為 NA
> m
   C1 C2 C3
R1 NA NA NA 
R2 99 99 99
R3 99 99 99
R4  4  8 12
> m[, 3] <- c(4, 5)   #第 3 行改為 c(4, 5) 套用循環規則
> m
   C1 C2 C3
R1 NA NA  4
R2 99 99  5
R3 99 99  4
R4  4  8  5


三. 矩陣的運算 :

1. 四則運算 :

矩陣與一個純量的加減乘除運算會作用在每一個元素上, 例如 :

gt; matrix(1:12, nrow=3)
     [,1] [,2] [,3] [,4]
[1,]    1    4    7   10
[2,]    2    5    8   11
[3,]    3    6    9   12
> matrix(1:12, nrow=3) + 1
     [,1] [,2] [,3] [,4]
[1,]    2    5    8   11
[2,]    3    6    9   12
[3,]    4    7   10   13
> matrix(1:12, nrow=3) - 1
     [,1] [,2] [,3] [,4]
[1,]    0    3    6    9
[2,]    1    4    7   10
[3,]    2    5    8   11
> matrix(1:12, nrow=3) * 2
     [,1] [,2] [,3] [,4]
[1,]    2    8   14   20
[2,]    4   10   16   22
[3,]    6   12   18   24
> matrix(1:12, nrow=3) / 2
     [,1] [,2] [,3] [,4]
[1,]  0.5  2.0  3.5  5.0
[2,]  1.0  2.5  4.0  5.5
[3,]  1.5  3.0  4.5  6.0

兩個矩陣也可以做四則運算, 即對應的元素做加減乘除運算, 但先決條件是維度須一樣, 即列數相同, 行數相同, 否則會出現 "非調和陣列" 的錯誤訊息, 例如 :

&> A <- matrix(1:12, nrow=3)
> A
     [,1] [,2] [,3] [,4]
[1,]    1    4    7   10
[2,]    2    5    8   11
[3,]    3    6    9   12
> B <- matrix(1:12, nrow=3)
> B
     [,1] [,2] [,3] [,4]
[1,]    1    4    7   10
[2,]    2    5    8   11
[3,]    3    6    9   12
> A+B                   #矩陣相加為對應元素相加
     [,1] [,2] [,3] [,4]
[1,]    2    8   14   20
[2,]    4   10   16   22
[3,]    6   12   18   24
> A-B                    #矩陣相減為對應元素相減
     [,1] [,2] [,3] [,4]
[1,]    0    0    0    0
[2,]    0    0    0    0
[3,]    0    0    0    0
> A*B                     #矩陣相乘為對應元素相乘 (Hardamard 乘積)
     [,1] [,2] [,3] [,4]
[1,]    1   16   49  100
[2,]    4   25   64  121
[3,]    9   36   81  144
> A/B                      #矩陣相除為對應元素相除
     [,1] [,2] [,3] [,4]
[1,]    1    1    1    1
[2,]    1    1    1    1
[3,]    1    1    1    1
> C <- matrix(1:12, nrow=4)    #C 為 4 列 3 行矩陣
> C
     [,1] [,2] [,3]
[1,]    1    5    9
[2,]    2    6   10
[3,]    3    7   11
[4,]    4    8   12
> A+C           #C 為 4 列 3 行矩陣, A 為 3 列 4 行矩陣, 維度不同無法運算
Error in A + C : 非調和陣列

另外, 矩陣也可以與向量做四則運算, 但條件是向量的長度必須與矩陣的列數相同, 例如 :

> A <- matrix(1:6, nrow=3)  #矩陣 A 為 3 列 2 行
> A
     [,1] [,2]
[1,]    1    4
[2,]    2    5
[3,]    3    6
> A + 1:3     #向量長度為 3, 與矩陣列數相同 : 可四則運算
     [,1] [,2]
[1,]    2    5
[2,]    4    7
[3,]    6    9
> 1:3 + A
     [,1] [,2]
[1,]    2    5
[2,]    4    7
[3,]    6    9
> A - 1:3
     [,1] [,2]
[1,]    0    3
[2,]    0    3
[3,]    0    3
> 1:3 - A
     [,1] [,2]
[1,]    0   -3
[2,]    0   -3
[3,]    0   -3
> A * 1:3
     [,1] [,2]
[1,]    1    4
[2,]    4   10
[3,]    9   18
> 1:3 * A
     [,1] [,2]
[1,]    1    4
[2,]    4   10
[3,]    9   18
> A / 1:3
     [,1] [,2]
[1,]    1  4.0
[2,]    1  2.5
[3,]    1  2.0
> 1:3 / A
     [,1] [,2]
[1,]    1 0.25
[2,]    1 0.40
[3,]    1 0.50

可見此向量是跟矩陣的每一行做運算的, 因此可以把向量看成是列向量 (雖然 R 語言的向量並無維度). 其實向量的長度只要不大於矩陣的列數就可以, 這時運算時會套用循環規則, 例如 :

> A
     [,1] [,2]
[1,]    1    4
[2,]    2    5
[3,]    3    6
> A + 1:2     #向量長度為 2 < 矩陣列數 3 (套用循環規則)
     [,1] [,2]
[1,]    2    6
[2,]    4    6
[3,]    4    8
> A + 1:4     #向量長度為 4 > 矩陣列數 3  (無法運算)
     [,1] [,2]
[1,]    2    8
[2,]    4    6
[3,]    6    8
Warning message:
In A + 1:4 : 較長的物件長度並非較短物件長度的倍數 

這裡 A + 1:2 的第一行 [2 4 4] 是 [1 2 3] + [1 2 1] 而得, 其餘類推.

2. 矩陣的內積 : 

上面的 A*B 稱為阿達馬乘積 (Hardamard 乘積), 兩個矩陣 A 與 B 的阿達馬乘積 A*B 是對應元素相乘, 其條件是兩矩陣的維度必須相同 (即均為 m*n 矩陣); 而矩陣的內積 A%*%B 則是 A 的列與 B 的行元素的對應乘積和組成的矩陣, 因此內積可乘之條件是矩陣 A 的列數須等於矩陣 B 的行數, 亦即若矩陣 A 為 m*n, 矩陣 B 為 n*p, 則 A%*%B 結果將得到一個 m*p 的矩陣, 維度相等之方陣必定是內積可乘.  例如 :

> A <- matrix(1:6, nrow=3)    #A 為 3*2 矩陣
> A
     [,1] [,2]
[1,]    1    4
[2,]    2    5
[3,]    3    6
> B <- matrix(1:6, nrow=2)     #B 為 2*3 矩陣
> B
     [,1] [,2] [,3]
[1,]    1    3    5
[2,]    2    4    6
> A %*% B        #A 與 B 之內積
     [,1] [,2] [,3]
[1,]    9   19   29
[2,]   12   26   40
[3,]   15   33   51
> B %*% A        #B 與 A 之內積
     [,1] [,2]
[1,]   22   49
[2,]   28   64

執行 A 與 B 之內積運算時, A 的第一列元素與 B 的第一行對應相乘再相加, 1*1 + 4*2=9 即為結果矩陣之 [1,1] 元素, 其餘類推.

若兩個矩陣 A, B 均有行列名稱且內積可乘, 則其內積 A%*% B 將保留前者 A 的列名與後者 B 的行名作為結果矩陣之行列名稱, 例如 :

> A=matrix(1:12, 4)       #A 為 4*3 矩陣
> rownames(A) <- c("R1","R2","R3","R4")
> colnames(A) <- c("C1","C2","C3")
> A
   C1 C2 C3
R1  1  5  9
R2  2  6 10
R3  3  7 11
R4  4  8 12
> B=matrix(1:12, 3)       #B 為 3*4 矩陣
> rownames(B) <- c("1st","2nd","3rd")
> colnames(B) <- LETTERS[1:4]      #使用大寫字母向量
> B
    A B C  D
1st 1 4 7 10
2nd 2 5 8 11
3rd 3 6 9 12
> A %*% B          # A 與B 內積會保留 A 之列名與 B 之行名
    A   B   C   D 
R1 38  83 128 173
R2 44  98 152 206
R3 50 113 176 239
R4 56 128 200 272

3. 轉置矩陣運算 t() : 

所謂轉置矩陣是將矩陣的列與行互換所成之矩陣, R 語言提供 t() 函數可執行轉置運算 (transpose), 例如 :

> A <- matrix(1:12, nrow=3)
> A
     [,1] [,2] [,3] [,4]
[1,]    1    4    7   10
[2,]    2    5    8   11
[3,]    3    6    9   12
> t(A)
     [,1] [,2] [,3]
[1,]    1    2    3
[2,]    4    5    6
[3,]    7    8    9
[4,]   10   11   12

一個矩陣 A 與其轉置矩陣 t(A) 因其行列互換後相同必定是內積可乘, 不論 A %*% t(A) 或 t(A) %*% 均可乘, 例如 :

> A %*% t(A)   
     [,1] [,2] [,3]
[1,]  166  188  210
[2,]  188  214  240
[3,]  210  240  270
> t(A) %*% A 
     [,1] [,2] [,3] [,4]
[1,]   14   32   50   68
[2,]   32   77  122  167
[3,]   50  122  194  266
[4,]   68  167  266  365

矩陣若有行列名稱, 則轉置時也會隨同轉置, 例如 :

> A=matrix(1:12, 4)
> rownames(A) <- c("R1","R2","R3","R4")
> colnames(A) <- c("C1","C2","C3")
> A
   C1 C2 C3
R1  1  5  9
R2  2  6 10
R3  3  7 11
R4  4  8 12
> t(A)               #轉置時行列名稱也會一起轉置
   R1 R2 R3 R4 
C1  1  2  3  4
C2  5  6  7  8
C3  9 10 11 12

4. 矩陣元素和與平均值運算 :

R 語言中提供下列函數計算矩陣之行列和與平均值 :

rowSums(x) 計算列總和
colSums(x) 計算行總和
rowMeans(x) 計算列平均
colMeans(x) 計算行平均
sum(x) 計算矩陣全部元素和
mean(x) 計算矩陣全部元素平均值

例如 :

> A <- matrix(1:6, nrow=2)
> A
     [,1] [,2] [,3]
[1,]    1    3    5
[2,]    2    4    6
> rowSums(A)
[1]  9 12
> colSums(A)
[1]  3  7 11
> rowMeans(A)
[1] 3 4
> colMeans(A)
[1] 1.5 3.5 5.5
> sum(A)
[1] 21
> mean(A)
[1] 3.5

5. 用 det() 求矩陣之行列式值 :

行列式 (determinant) 是將方陣映射到一個純量的函數, 其值為方陣中向右對角線元素乘積和減向左對角線元素乘積和, 可用 det() 函數求得, 例如

> A <- matrix(1:4, 2)
> A
     [,1] [,2]
[1,]    1    3
[2,]    2    4
> det(A)
[1] -2
> A=matrix(1:9, 3)
> A
     [,1] [,2] [,3]
[1,]    1    4    7
[2,]    2    5    8
[3,]    3    6    9
> det(A)
[1] 0

注意. 只有方陣才有行列式值 :

> A <- matrix(1:6, 2)
> A
     [,1] [,2] [,3]
[1,]    1    3    5
[2,]    2    4    6
> det(A)         #
Error in determinant.matrix(x, logarithm = TRUE, ...) :
  'x' must be a square matrix

6. 用 solve() 函數求逆矩陣 : 

所謂逆矩陣是指, 若一個 n 階方陣 A, 存在一個 n 階方陣 B 使得 A 與 B 之內積為一 n 階單位方陣, 則稱 A 為可逆, 而 B 為其逆矩陣. 注意, 可逆矩陣一定是方陣, 但方陣並不一定是可逆, 只有非奇異方陣 (即其行列式值不為 0 者) 才有逆矩陣, 參考 :

# https://zh.wikipedia.org/wiki/逆矩阵

例如 :

> A=matrix(1:4, 2)
> A
     [,1] [,2]
[1,]    1    3
[2,]    2    4
> solve(A)
     [,1] [,2]
[1,]   -2  1.5
[2,]    1 -0.5

逆矩陣是很重要的矩陣運算, 例如在解線性方程組 Ax=B 時就要用到反矩陣, R 語言提供 solve() 函數來計算反矩陣 :

x=solve(A) %*% B

例如下列二元一次方程組 :

x + 3y=4
2x + 4y=6

其解即可用係數矩陣之逆矩陣與常數項矩陣之內積求得 :

> solve(A) %*% matrix(c(4,6), nrow=2)
     [,1]
[1,]    1
[2,]    1
> solve(A) %*% c(4,6)     #用向量也可以 matrix(c(4,6), nrow=2)
     [,1]
[1,]    1
[2,]    1

即其解為 x=1, y=1.

7. 用 eigen() 求特徵值與特徵向量 :

一個方陣 (square matrix) A 的特徵向量 V 是指 V 經過方陣 A 的線性變換後, 結果與 V 保持純量關係, 即 AV=eV, 其中 e 為一純量, 代表向量 V 經過線性變換後之縮放比例, 特徵值為正表示向量 V 方向不變; 反之為負表示方向相反. e 稱為方陣 A 之特徵值, V 為其特徵向量, 參考 : 

# https://zh.wikipedia.org/wiki/特征值和特征向量

> A <- matrix(1:12, nrow=4)                         #建立 4*3 矩陣 (非方陣)
> eigen(A)
Error in eigen(A) : non-square matrix in 'eigen'      #方陣才有特徵值
> A <- matrix(1:9, nrow=3)                            #建立 3*3 方陣
> eigen(A)                                                           #計算特徵值與特徵向量
eigen() decomposition
$values                                                                      #特徵值
[1]  1.611684e+01 -1.116844e+00 -5.700691e-16

$vectors                                                                     #特徵向量
           [,1]       [,2]       [,3]
[1,] -0.4645473 -0.8829060  0.4082483
[2,] -0.5707955 -0.2395204 -0.8164966
[3,] -0.6770438  0.4038651  0.4082483
> V["values"]                                                        #取得特徵值
$values
[1]  1.611684e+01 -1.116844e+00 -1.303678e-15

> V["vectors"]                                                       #取得特徵向量
$vectors
           [,1]        [,2]       [,3]
[1,] -0.2319707 -0.78583024  0.4082483
[2,] -0.5253221 -0.08675134 -0.8164966
[3,] -0.8186735  0.61232756  0.4082483
> V <- eigen(A)           
> class(V)
[1] "eigen" 
> class(V["values"])     #特徵值是 list 類型
[1] "list"
> class(V["vectors"])    #特徵向量是 list 類型
[1] "list"

可知 eigen() 函數傳回值為 eigen 類型之物件, 其內有 values (特徵值) 與 vectors (特徵向量) 兩個屬性, 都是 list 類型資料.


四. 矩陣常用函數 :

與矩陣相關之常用函數如下表 :

 函數 說明
 matrix(data, nrow, ncol, byro)
 str(x) 顯示物件結構與內容
 length(x) 顯示矩陣元素個數
 dim(x) 顯示物件 (矩陣, 陣列, 資料框) 維度
 nrow(x) 顯示矩陣列數
 ncol(x) 顯示矩陣行數
 is.matrix(x) 檢查是否為矩陣類型
 as.matrix(x) 將物件強制轉型為矩陣類型
 rbind(v1, v2, ...) 將多個向量以列向量方式組成矩陣
 cbind(v1, v2, ...) 將多個向量以行向量方式組成矩陣
 diag(x=1, nrow, ncol) 以 x 為軸建立 nrow 列, ncol 行之矩陣 (nrow=ncol 時對稱)
 rownames(x) 取得矩陣的列名
 colnames(x) 取得矩陣的行名
 dimnames(x) 取得矩陣的維度資訊 (含列名與欄名)
 rowSums(x) 計算矩陣列總和
 colSums(x) 計算矩陣行總和
 rowMeans(x) 計算矩陣列平均
 colMeans(x) 計算矩陣行平均
 sum(x) 計算矩陣全部元素和
 mean(x) 計算矩陣全部元素平均值
 det(x) 計算方陣之行列式值
 solve(x) 求方陣之逆矩陣
 eigen(x) 計算矩陣之特徵值與特徵向量

參考 :

# R语言基础:矩阵
# 利用 matrix 建立矩陣
# 矩阵基本操作
# R Tutorial : matrix
# R 向量、矩陣與陣列