2018年6月30日 星期六

好站 : 使用 Arduino IDE 開發 ESP32+LoRa 應用

今天在 Randan Nerd Tutorial 網站找到下面這篇文章 :

# ESP32 with LoRa using Arduino IDE – Getting Started

作者使用 ESP32 當主控, 透過 SPI 介面與 LoRa 模組連接, 利用 Arduino IDE 編譯程式後上傳韌體, 這樣兩個 ESP32 就可以透過 LoRa 通訊了. LoRa 從去年做過初步測試就沒時間玩, 那時是用 Arduino 當主控, 有空要 ESP8266 來試試.

2018-07-01 補充 :

感謝好友 Jason 分享了下面這篇, 先記下來有空再試 :

http://wei1234c.blogspot.com/2017/08/sx127x-lora-transceiver-driver-for.html?m=1
wei1234c.blogspot.com - SX127x (LoRa transceiver) driver for (Micro)Python on ESP8266/ESP32/Raspberry_Pi

好書 : 網頁應用程式設計-使用 Node 和 Express

早上載二哥去河堤分館後就直接去母校高科大還書, 花了兩個小時把 2, 3 樓藏書尋了一遍, 覺得還是有蠻多書想借, 可惜十本額度已借滿借好, 爆表了. 不過下面這本非借不可 :

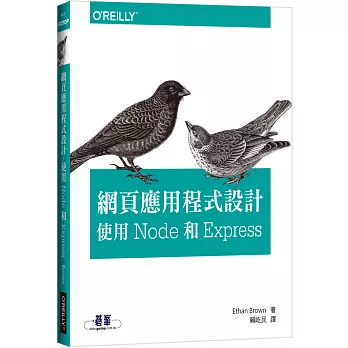
# 網頁應用程式設計-使用 Node 和 Express (歐萊里出版, 賴屹民譯)


Source : 博客來


若要在樹莓派上建物聯網網站, 我認為用 Node.js 最適合, 無阻塞式 I/O 比較不會讓頻繁的物聯網存取塞車, 用在 Fintech 金融資訊運算儲存也很適合. 為了借這本書, 我把目前沒時間看的 "資料科學的商業運用" 這本還回去了, 沒辦法, 凡是總是要取捨, 而且人心很奇怪, 當你擁有的時候不覺得珍貴, 沒有的時候就想要得不得了.

Win 10 安裝 Movie Maker

因為水某要用 Movie Maker 製作影片, 發現 Win 10 並未內建 Movie Maker, 而且微軟官網聲明已不再支援 Movie Maker 下載 :

# Windows Movie Maker 已不再提供下載

而且提醒 :  "提供免費下載 Movie Maker 的網站並非提供真正的程式,這些下載項目可能包含惡意軟體、病毒或隱藏費用。"

我找到下面這個 Win 10 版的大約 79MB, 經掃描沒有病毒之類的 :

# Windows Movie Maker 多語言版本安裝包下載

安裝後確實可用.

2019-11-29 補充 :

有網友表示此 Movie Maker 並非微軟所開發, 或者輸出時要求付費等問題, 與我當時安裝使用經驗不同, 建議若與預期有異勿安裝, 我找時間翻找之前微軟版光碟看看. 

2018年6月29日 星期五

關於麗星郵輪之旅

前天收到公司福委會轉發的麗星郵輪宮古島那霸旅遊優惠方案, 五天四夜高級海景房約 15800 元, 且免港務費與小費, 似乎蠻優惠的. 中午問爸有無興趣, 他說 OK 昨天我即傳真報名. 水某也想去, 但菁菁卻意興闌珊, 姊姊則無回應. 也問了舅舅與舅媽, 她說她會暈船.

事實上此行程大部分都在郵輪上, 僅在宮古島與那霸個停留約 8~11 小時, 大都認為沒多少時間攬勝. 確實如此, 下船時間不是下午 1 點就是 3 點 (宮古島), 老實說只能選一條路導覽路線而已. 宮古島琉球位置如下 :


航線為高雄港 - 巴士海峽 - 台灣東岸 - 宮古島 - 那霸.

2018-07-02 收到鋼友旅行社資料, 其中注意事項如下 :

  1. 請攜帶個人慣用之藥品及自備盥洗用具
    ★拖鞋請自備。 (牙膏、牙刷、毛巾等…船上也有提供) 
  2. 金錢:不可攜帶超過美金一萬元等值外幣(旅行支票或銀行匯票不限)
    新台幣不可超過六萬元。
  3. 請攜帶個人有效證件以及COPY本(護照正本有效期限六個月以上)辦理登船手續。
    ★★★請注意役男的身份,依照境管局規定88年次以前未服兵役者,需要蓋兵役章
  4. 孕婦必須出示醫師證明適合在船上旅遊
    ★★★懷孕24星期以上之孕婦不能登船航遊★★★。
  5. 未滿6個月嬰兒(24星期以下)及年滿90歲以上的旅客,不接受訂位。 
  6. 如遇不可抗拒之因素(如颱風等),依照麗星郵輪規定;麗星郵輪保有取消或更改既定 航程、時間、船舶及價格之權利,恕不預先通知,請參照麗星郵輪旅遊要項需知 (旅客需簽回)。 
  7. 請於〝報到時間~關閘前半小時〞須辦理登船報到,如有延誤請自行負責。 
  8. 自行攜帶護照之旅客,請另行備妥A4護照影本1份 (一定要 A4, 不可裁切),以供日本海關查驗。請留意,在整個旅程中,我們的登輪部門會為您保管您的護照,在航程結束後才歸還給您。
  9. 因岸上觀光遊覽車數量有限,如欲報名岸上行程之旅客請出發前一星期預約。 
  10. 麗星郵輪規定,為維護航程安全問題,嚴禁攜帶Samsung Galaxy Note7手機、對講機上船。 11.麗星郵輪規定,任何酒精飲品(啤酒/葡萄酒/烈酒)將不允許攜帶上郵輪。

好奇的是為何指名 Note 7 手機?

關於報到與登輪還需注意下列事項 :

報到
  1. 請貴賓依您購買的艙房於報到大廳辦理報到手續。
  2. 建議貴賓於接駁巴士下車處先辦理托運行李手續。(行李會由郵輪人員送至您的房間)
  3. 報到時請出示您的護照,工作人員會將您的護照、船卡(房卡)、日本出境卡、日本海關單、岸上觀光資料(若有購買)、船上晚宴預約單(若有)一起交給您,再排隊前往通關登船。
登上郵輪
  1. 請事先準備護照(有照片頁)影印本,一定要A4尺寸(不可裁切)1:1比例(不可放大/縮小),每次上下船連同船卡均要隨身攜帶。
  2. 登上郵輪之前,乘客必須經過保安審查及出示登船卡。
  3. 帶小朋友同遊的乘客請代為保管他們的登船卡,避免遺失。
  4. 登上郵輪後,請遞上您的登船卡,以便船員為您〝開卡〞和〝啓用〞您的客房資料,以及記錄您已經登上郵輪。
  5. 若您沒有〝開卡〞的情況下直接通過,您將無法進入您的客房。
  6. 切記每當上下郵輪時必須〝過卡〞。
兒童信用限制 :

如果您希望凍結小朋友登船卡之購買記帳功能,請前往7樓接待處(服務台)辦理。不然,小朋友如果在您不知情的情況下徑自使用登船卡購買物品或服務,您必須得為小朋友所簽記的款項負起責任。

遺失登船卡 :

若您不慎遺失登船卡,請立即向7樓接待處(服務台)報失以補發新卡及取消遺失的登船卡。以避免為帳額不符而負責。
請在您的登船卡背面簽上大名。 套房級及一般客房之乘客將個別獲得黃色、紅色及藍色的登船卡。

登船卡的功能:
  1. 登輪通行卡。
  2. 開啟您客房的鑰匙 
  3. 船上的身份証明。
  4. 餐廳用餐通行証。 
  5. 消費記帳卡。
行程如下 :

7/8 11:30 開始報到, 須於關閘 (13:30) 前半小時, 即 13:00 前報到. 登輪地點在高雄市蓬萊路棧 9-2 號碼頭, 港區管制私人車輛無法進入, 須搭接駁車, 搭車地點在七賢路底與蓬萊路口之香蕉碼頭.


行程說明手冊重要資訊整理如下 :
  1. 進入公海後手機訊號為經過衛星電話線路 (以分計費), 非必要最好關閉行動通話功能.
  2. 船上特定地點有付費 WiFi, 按日 (280 元) 或套餐收費
  3. 地毯顏色判別位置在船頭 (紅色), 船中 (藍色), 船尾 (綠色)
  4. 房間都會有洗髮精, 沐浴乳, 牙膏, 牙刷, 浴巾及浴帽, 但拖鞋自備
  5. 共有四間免費餐廳 (9F 王朝, 11F 香味軒, 9F 奧珊娜燒烤, 12F 航海家). 每一用餐時段只能選擇其中一家餐廳. 宵夜僅王朝與航海家提供. 
  6. 岸上觀光注意 : 船上熟食不可帶下船, 岸上生魚片不可帶上船, 水果食品不可入境
  7. 離岸後手機無法使用, 7F 接待處有衛星電話可用, 打台灣每分鐘 62.5 元
  8. 回港前一天晚上先結清款項, 以免次日擁擠
關於旅遊平安險問題, 一般搭機刷卡支付團費 8 成以上送旅遊平安險與不便險等優惠並不包括搭乘郵輪旅遊, 參考 :

# 信用卡旅綜險 不承保郵輪
# 別省這個錢! 刷卡贈旅平險 搭郵輪不在保障範圍

不過有少數銀行信用卡例如台企銀, 兆豐金, 凱基銀, 中國信託信用卡旅遊平安險有包含郵輪, 其中中國信託只限麗星郵輪, 參考 :

# 信用卡旅平險總整理 航空高鐵台鐵全都保

我有一張中國信託國旅卡金卡, 問了中國信託客服, 說詳細要問承保的台壽保公司 (0800-882868), 我問的結果是只含旅遊平安險, 不包含不便險與醫療險, 需另外投保.

參考 :

# http://kimbella.pixnet.net/blog/post/180836004-搭麗星郵輪心得-%26-注意事項
# elsy310.pixnet.net/blog/post/112191382-%28麗星郵輪.寶瓶星號%29-船上設施
# 寶瓶星號-乘客常見問題 (FAQ)
# 強烈建議不要搭麗星郵輪!!  (這是反話)
# 上順旅行社寶瓶星客房種類
# 2016年麗星郵輪行前準備及工具包

2018-07-02 補充 :

下午已傳真合約書, 協議書, 刷卡單, 以及護照影本給旅行社, 費用 34800 元, 含宮古岸上觀光 (1800*2) 與那霸岸上觀光 (1600*2) 共 6800 元.

# 行程被改 下船延誤 數百位台灣旅客海上抗議
# 出國換匯怎樣不吃虧? 臨櫃最不划算 這方式匯率較優
# 明台產物保險網路投保


2018年6月26日 星期二

購買有 HDMI 輸入之液晶螢幕

因鄉下樹莓派使用的 XP 時代 ViewSonic 螢幕已經很兩光, 有時會突然斷訊, 所以上露天找到下面這款有 HDMI 輸入介面的 15.6 吋螢幕取代, 這家賣的螢幕是最便宜的, 適合做監視器, 但品牌是沒聽過的 BroadWatch, 品質不知如何, 權且使用看看, 總之是因為樹莓派輸出為 HDMI, 經過上回買的轉換頭轉成 VGA 總覺得不穩定, 如果螢幕有 HDMI 介面就不需要轉換了 :

# 寬屏15.6寸液晶屏高清VGA / HDMI/超薄壁掛顯示器 PS3/PS4/XBOX/樹莓派/戶外監控便攜式1080P $1680

含運 1680+60=1740 元

我打算把此螢幕放在客廳爸看書的小書桌, 把書房的 Pi 3 移到小書桌接到新螢幕上, 這樣如果要跟爸說明資料時我就可以透過 VNC 遠端連線進入 Pi 3 操作給他看.

2018-07-08 補充 :

此螢幕就只有電源, HDMI, VGA, 與 AUDIO 輸入孔, 另一側則是簡單的按壓式視訊調整按鈕與電源開關, 因為在背板不好關電源, 直接拔插頭比較方便. 

2023-02-04 補充 :

此螢幕背後內建兩個喇叭, 可以播放聲音與音樂. 

2018年6月25日 星期一

評估新手機

我的華為 Honor 3C 使用到現在已近 4 年, 最近覺得越來越卡, 所以動了換機的念頭. 之前二哥力推 HTC U11, 說 CPU 強壯有力,  CP 值很高, 我想他是從手遊角度看得吧, 高通 S835 評價真的不錯, GPU 也很棒,  不過我一直對 Note 8 念念不忘, 那隻 S Pen 可以在螢幕上手繪蠻吸引我的, 只是空機價格太貴. 最近 Zenfone 5 (高通 S636) 與 Zenfone 5Z (高通 S845) 推出後又覺得還不錯, 所以稍微對這三款進行了研究比較, 其實我對手機的要求只有以下幾點 :
  1. 雖然不玩遊戲, 但運算能力越強越好
  2. 通訊網速要盡可能快 (3CA 以上或 MIMO)
  3. 拍照效果要好 
我不是追流行頻頻換手機的人 (畢竟手機也不便宜), 但要能用起來順才行. 像現在常常要清記憶體才不會卡卡, 這就有點困擾. 但若要像同事那樣咬牙硬撐到 5G 出來, 我看還要等 3~4 年才會成熟順暢. 所以現在換手機只是為了過渡到 5G 時代的性能要求而已.

由於 Note 8 空機超過 2 萬元實在貴森森不予考慮, 只剩下 HTC U11 與 Zenfone 5/5Z 需要選擇而已. 其實 Zenfone 5Z 於六月開賣後我比較傾向於買 5Z, 但 U11 現在有降價, momo 賣 12935 送保護套 + 螢幕貼 + 行動電源, 但露天空機有更便宜的, 賣 11799, 差 1100 元, 參考 :

# HTC U11 (4G/64G) (空機) 全新未拆封 原廠公司貨 $11799
# HTC U11 4G/64G 5.5吋 贈TPU透明殼+5200行動電源+螢幕貼 智慧型手機 0利率 免運費 (momo) $12935 元
# 全新 HTC U11 U3U 128G 4G LTE 5.5吋 旗艦機 $12800
# 全新 HTC U11 6G/128G 雙卡防水防塵 Edge Sense握壓側框感應 3D水漾玻璃 U-3u【海棠數位】 $13190
# HTC U11 (6G/128G) (空機) 全新未拆封 原廠公司貨 X10 M10 X9 A9 S9 ULTRA $13399

U11 雖然已經是去年的舊產品, 但考慮到 CP 值到還可以考慮, 以下是 U11 的優缺點 :

U11 缺點 :
  1. 沒有 3.5mm 耳機孔, 附轉換頭
  2. 曲面螢幕較易摔壞
  3. 單鏡頭
  4. 據說毛病多 (?)
U11 優點 :
  1. CPU/GPU 強 (高通 S835)
  2. 拍照效果好
  3. 有 4CA 功能
  4. ROM 使用最快的 UFS2.1  
  5. 有側框感應功能, 拍照錄影等方便
  6. 有智慧數位助理
  7. 立體聲雙喇叭音量大效果好
  8. 兩年保固


U11 有一個大優點是其 ROM 用的是最快速的 UFS2.1, 而 Zenfone 5 用的是較慢的 eMMC, 不過 到了 5Z 就改用 UFS2.1 了, 效能優先考量, 其實應該考鎖定 5Z 就好, 參考 :

# 選Zenfone5 比較好還是U11比較好?
# Zenfone 5z 跟 5 大家比較愛哪個?
# 請問:zenfone5和zenfone5z的差別只在處理器嗎?

比較之後發現 Zenfone 5 規格當然跟 U11 沒得比, 但跟 Zenfone 5Z 比起來, U11 就有點弱了 (CPU 低一檔). 不過測框感應功能對照相確實非常方便, 可及時捕捉難得的畫面. Zenfone 5Z 規格確實是非常的優, 從 CPU, RAM, ROM, 到光學防手震等都有, 可說是高階旗艦機. 所以結論就是 : 買 Zenfone 5Z 6G/128G 款, 把規格一次買足.

我查了公司福利社有賣 Zenfone 5, 售價 11390 元, 但還沒有賣 Zenfone 5Z. 我今年福利點數還沒用, 那就拿來買 5Z 吧! 福利社廠商說原廠還沒報價, 要等一等. 反正我也不急, 只要年底前把福利點數用掉即可.

參考 :

# ASUS ZenFone 5揭曉 軟體、相機有AI加持、全螢幕也長瀏海了
# 華碩ZenFone 5、5Z與5 Lite發表 3月中起陸續上市[MWC 2018]
# 「手機選購」破解迷思 手機挑選.購買法則 (2018版)
# U11擠壓拍照是有沒有防手震?
# [討論] U11的4CA
# CA還不夠!什麼是4X4 MIMO?
# NCC 頻率資料庫查詢
# 高通S845跑分成績逆天,但單核成績依舊被蘋果A11輾壓 (還是蘋果厲害)
# Android 旗艦機最強大的處理器?高通 S845 帶來全新三大進化
# Alexa 智慧助理正式登上 HTC U11,但目前僅有美國玩得到

PS :

晚上在 mobile1 論壇看到有人介紹也是 6 月開賣的 Sharp S3 高配版 (同樣 6G/128G), 有無線充電功能, 但 CPU 比 Zenfone 5Z 的 S845 差兩檔次 (排老三), 用的是高通 S660, 現在 momo 與 PC Home 月底前都有促銷活動, 參考 :

# 全新未拆封 SHARP AQUOS S3 高配版 S660 6G/128G 無線充電版 iMos滿版玻璃貼 包膜優惠卷 $13990
# 【SHARP 夏普】AQUOS S3 6G+128G 高配版智慧機 momo $13990
# 首購送無線充電板+imos滿版玻璃保貼及包膜折價卷 限時刷星展送11% $13990

原本也很動心, CPU 差一點沒關係, 反正我不玩遊戲. 但載二哥回來的路上, 他說 CPU 對效能很重要, 應該買最高檔的 Zenfone 5Z, 無線充電目前效能比不上線充, 不一定需要. 而且他聽同學說 Sharp 手機之前有電池充電問題, 又讓我縮手了. 雖然有賣家以 13000 元優惠價格 (含促銷贈品) 要轉售未拆封 Sharp S3 高配版新機, 高 CP 值讓我非常心動, 但後來看到下面這篇, 就完全打消念頭了 :

# 自AQUOS S3上市購入至今使用感想! 小問題好多!!

總之, 現在先不要動, 等福利社 5Z 上架後再買. 根據 ASUS 官網 Zenfone 5 賣 11990 元估計, 福利社 Zenfone 5Z 報價應該在 16390 左右 (差價約 5000 元), 我大概還要補貼 8390 元.

2018年6月24日 星期日

2018 年第 25 周記事

下了一周的雨, 週三開始放晴, 但這幾天天氣仍不穩定. 下雨天真的很不方便, 因為我隨身總是要帶幾本書解悶, 寫程式時要查閱書卻不在身邊會非常苦惱.

鄉下的芒果開始收成了, 今年因花期逢雨, 海頓結果率太差, 上個月芒果套袋時感覺大約 100 顆左右, 還好只是屋子周圍種來遮陰只有 7, 8 棵, 全部自用送親友. 如果是種來出售, 這種一年一獲花期又怕雨的水果要怎麼過活啊! 農人真是靠天吃飯的命.

這兩天在 MOD 瘋狂看了 4 部片 : 兩部日片 (冰果, 跟爺爺說再見)  , 兩部韓片 (興夫-撼動朝鮮的文學家, 屍蹤七號房), 除了 "屍蹤七號房" 我覺得還好外 (黑色喜劇), 其他都帶給我不一樣的感受.

"冰果" 中的折木奉太郎那個節能至上主義令我印象深刻 : "非必要的事絕對不做, 必要的事盡速解決", 這哲學還真合我的口味, 只是心軟的我總是禁不起拜託與慈悲心撩落去, 盡幹一些浪費時間的事. 冰果原來是 I scream 的諧音, 意思是吶喊, 想要傳達的是懦弱隱忍而不敢大聲為自己辯護, 最後可能喪失理想而形同行屍走肉一般. 另外千反田同學的 "我很好奇" 哲學帶來的啟示是 : 當我們對世間不再好奇, 其實也就是行屍走肉了. "跟爺爺說再見" 我覺得風格有點類似台灣電影 "父後七日", 但描寫更多家庭手足親情的衝突, 不過都對中日兩國的喪禮做了大致的描述.

最近要集中火力學習 Python 應用, 我覺得自己太花心, 這裡也想那裏也想終究備多力分. 巴菲特認為找到好股就要重押, 把雞蛋放在不同的籃子裡固然分散了風險, 但也分散了利潤. 重點在找到不會破的金雞蛋後, 要把它們全部放在同一個籃子裡才能放大獲利. 學習也是如此.

樹莓派安裝 Python 編輯器 Thonny

今天在 Pi 3 上也安裝了 Thonny 編輯器, 安裝指令為 :

sudo apt-get install python3-thonny

參考 :

# THONNY ON A RASPBERRY PI: USING THE NEW PYTHON IDE IN RASPBIAN
# Installing Thonny on existing set up

安裝過程如下 :

Debian GNU/Linux comes with ABSOLUTELY NO WARRANTY, to the extent
permitted by applicable law.
Last login: Sun May 13 15:05:30 2018 from 192.168.2.121
pi@raspberrypi:~ $ sudo apt-get install python3-thonny 
Reading package lists... Done
Building dependency tree
Reading state information... Done
The following extra packages will be installed:
  python-chardet-whl python-colorama-whl python-distlib-whl
  python-html5lib-whl python-pip-whl python-requests-whl python-setuptools-whl
  python-six-whl python-urllib3-whl python3-jedi python3-venv python3.4-venv
The following NEW packages will be installed:
  python-chardet-whl python-colorama-whl python-distlib-whl
  python-html5lib-whl python-pip-whl python-requests-whl python-setuptools-whl
  python-six-whl python-urllib3-whl python3-jedi python3-thonny python3-venv
  python3.4-venv
0 upgraded, 13 newly installed, 0 to remove and 214 not upgraded.
Need to get 2,859 kB of archives.
After this operation, 4,594 kB of additional disk space will be used.
Do you want to continue? [Y/n] y
Get:1 http://mirrordirector.raspbian.org/raspbian/ jessie/main python-chardet-whl all 2.3.0-1 [170 kB]
Get:2 http://mirrordirector.raspbian.org/raspbian/ jessie/main python-colorama-whl all 0.3.2-1 [20.2 kB]
Get:3 http://archive.raspberrypi.org/debian/ jessie/main python3-jedi all 0.10.2 [127 kB]
Get:4 http://mirrordirector.raspbian.org/raspbian/ jessie/main python-distlib-whl all 0.1.9-1 [141 kB]
Get:5 http://mirrordirector.raspbian.org/raspbian/ jessie/main python-html5lib-whl all 0.999-3 [112 kB]
Get:6 http://mirrordirector.raspbian.org/raspbian/ jessie/main python-six-whl all 1.8.0-1 [14.8 kB]
Get:7 http://archive.raspberrypi.org/debian/ jessie/main python3-thonny all 2.1.10-1+rpi3~jessie [158 kB]
Get:8 http://mirrordirector.raspbian.org/raspbian/ jessie/main python-urllib3-whl all 1.9.1-3 [76.8 kB]
Get:9 http://mirrordirector.raspbian.org/raspbian/ jessie/main python-requests-whl all 2.4.3-6 [241 kB]
Get:10 http://mirrordirector.raspbian.org/raspbian/ jessie/main python-setuptools-whl all 5.5.1-1 [233 kB]
Get:11 http://mirrordirector.raspbian.org/raspbian/ jessie/main python-pip-whl all 1.5.6-5 [126 kB]
Get:12 http://mirrordirector.raspbian.org/raspbian/ jessie/main python3.4-venv armhf 3.4.2-1 [1,438 kB]
Get:13 http://mirrordirector.raspbian.org/raspbian/ jessie/main python3-venv armhf 3.4.2-2 [1,100 B]
Fetched 2,859 kB in 13s (213 kB/s)
Selecting previously unselected package python-chardet-whl.
(Reading database ... 123711 files and directories currently installed.)
Preparing to unpack .../python-chardet-whl_2.3.0-1_all.deb ...
Unpacking python-chardet-whl (2.3.0-1) ...
Selecting previously unselected package python-colorama-whl.
Preparing to unpack .../python-colorama-whl_0.3.2-1_all.deb ...
Unpacking python-colorama-whl (0.3.2-1) ...
Selecting previously unselected package python-distlib-whl.
Preparing to unpack .../python-distlib-whl_0.1.9-1_all.deb ...
Unpacking python-distlib-whl (0.1.9-1) ...
Selecting previously unselected package python-html5lib-whl.
Preparing to unpack .../python-html5lib-whl_0.999-3_all.deb ...
Unpacking python-html5lib-whl (0.999-3) ...
Selecting previously unselected package python-six-whl.
Preparing to unpack .../python-six-whl_1.8.0-1_all.deb ...
Unpacking python-six-whl (1.8.0-1) ...
Selecting previously unselected package python-urllib3-whl.
Preparing to unpack .../python-urllib3-whl_1.9.1-3_all.deb ...
Unpacking python-urllib3-whl (1.9.1-3) ...
Selecting previously unselected package python-requests-whl.
Preparing to unpack .../python-requests-whl_2.4.3-6_all.deb ...
Unpacking python-requests-whl (2.4.3-6) ...
Selecting previously unselected package python-setuptools-whl.
Preparing to unpack .../python-setuptools-whl_5.5.1-1_all.deb ...
Unpacking python-setuptools-whl (5.5.1-1) ...
Selecting previously unselected package python-pip-whl.
Preparing to unpack .../python-pip-whl_1.5.6-5_all.deb ...
Unpacking python-pip-whl (1.5.6-5) ...
Selecting previously unselected package python3-jedi.
Preparing to unpack .../python3-jedi_0.10.2_all.deb ...
Unpacking python3-jedi (0.10.2) ...
Selecting previously unselected package python3.4-venv.
Preparing to unpack .../python3.4-venv_3.4.2-1_armhf.deb ...
Unpacking python3.4-venv (3.4.2-1) ...
Selecting previously unselected package python3-venv.
Preparing to unpack .../python3-venv_3.4.2-2_armhf.deb ...
Unpacking python3-venv (3.4.2-2) ...
Selecting previously unselected package python3-thonny.
Preparing to unpack .../python3-thonny_2.1.10-1+rpi3~jessie_all.deb ...
Unpacking python3-thonny (2.1.10-1+rpi3~jessie) ...
Processing triggers for man-db (2.7.0.2-5) ...
Processing triggers for gnome-menus (3.13.3-6) ...
Processing triggers for desktop-file-utils (0.22-1) ...
Processing triggers for mime-support (3.58) ...
Setting up python-chardet-whl (2.3.0-1) ...
Setting up python-colorama-whl (0.3.2-1) ...
Setting up python-distlib-whl (0.1.9-1) ...
Setting up python-html5lib-whl (0.999-3) ...
Setting up python-six-whl (1.8.0-1) ...
Setting up python-urllib3-whl (1.9.1-3) ...
Setting up python-requests-whl (2.4.3-6) ...
Setting up python-setuptools-whl (5.5.1-1) ...
Setting up python-pip-whl (1.5.6-5) ...
Setting up python3-jedi (0.10.2) ...
2018-06-19 19:50:03 py2deb.hooks[30274] INFO Generated 56 Python bytecode files(s) for python3-jedi package.
Setting up python3.4-venv (3.4.2-1) ...
Setting up python3-venv (3.4.2-2) ...
Setting up python3-thonny (2.1.10-1+rpi3~jessie) ...

安裝完畢後在 Programming 工具集中就可找到 Thonny Python IDE 了, 操作方式與 Windows 上完全相同, 參考 :

# 好用的 Python 編輯器 Thonny


不過與 Windows 上不同的是, 安裝好後 Python 解譯器會先指向本機 Python 而非 Thonny 自帶的 BundledPython, 開啟 "Tools/Options" 確實是本機的 /usr/bin/Python3.4 :


因此開啟 "Tools/Manage Packages" 視窗時會出現一大堆已安裝套件列表 :


與 Windows 上一樣, 由於不是自帶的 Python, 無法在此 GUI 介面安裝/升級/刪除套件. 但可開啟 "Tools/Open system shell" 來進行操作, 例如升級 pip3 :

pi@raspberrypi:~ $ sudo -H pip3 install --upgrade pip
Downloading/unpacking pip from https://files.pythonhosted.org/packages/0f/74/ecd13431bcc456ed390b44c8a6e917c1820365cbebcb6a8974d1cd045ab4/pip-10.0.1-py2.py3-none-any.whl#sha256=717cdffb2833be8409433a93746744b59505f42146e8d37de6c62b430e25d6d7
  Downloading pip-10.0.1-py2.py3-none-any.whl (1.3MB): 1.3MB downloaded
Installing collected packages: pip
  Found existing installation: pip 1.5.6
    Not uninstalling pip at /usr/lib/python3/dist-packages, owned by OS
Successfully installed pip
Cleaning up...
pi@raspberrypi:~ $ pip3 -V
pip 1.5.6 from /usr/lib/python3/dist-packages (python 3.4)

2018年6月23日 星期六

好書 : 高效率資料分析-使用 Python

昨天從市圖總館借到下面這本好書 :

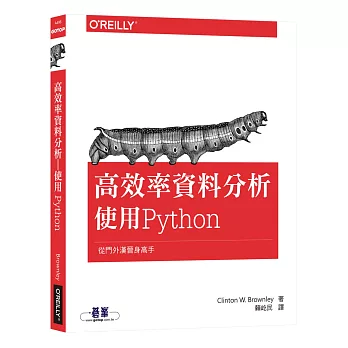
#  高效率資料分析-使用 Python (歐萊里出版, Clinton W. Brownley 著, 賴屹民譯)


Source : 博客來


這本書是美商 Oreilly 出版的 "Fundations for Analytics with Python" 的中譯本, 此書可說是進入資料科學非常棒的 Data wrangling 入門書, 詳細介紹了如何使用 Python 處理 CSV 與 EXCEL 檔案中的資料為 Python 資料科學可用的形式 (即 DataFrame), 並將其儲存於 sqlite3 或 MySQL 資料庫, 此外還介紹了 matplotlib, pandas, ggplot, seaborn 等資料繪圖工具, 以及資料的描述統計與模型建立等等.

書中的範例程式可於 GitHub 中下載 :

# http://github.com/cbrownley/fundations-for-analytics-with-python

2018年6月22日 星期五

Python 學習筆記 : 網頁擷取 (一) 使用 urllib 與 HTMLParser

上個月測試完 Python 的 SQLite 與 MySQL 資料庫操作後, 本來想要繼續測試 NoSQL 資料庫 (例如 MongoDB), 但想想有 SQLite 與 MySQL 應該就夠用了. 我比較急著想要測試的是 Python 的網頁擷取功能, 也就是撰寫網路爬蟲程式.

所謂網頁擷取 (Web scraping) 是指利用程式下載網頁並從中擷取資訊的技術, 這種技術極具變化性與挑戰性, 因為每一個目標網頁呈現內容的方式都不同, 因此沒有一個通用的資料擷取函數可用, 必須依要探索之目標網頁量身訂做. 這種專門設計用來擷取網頁內容的程式稱為網路爬蟲 (Web crawler/scrapper), 例如 Google 便是利用網路爬蟲取得 Internet 上的網頁內容以便製作搜尋引擎所需之索引.

理想上, 如果每一個網站都有提供 API 讓使用者下載網頁內容之結構化格式 (如 JSON 或 XML 等) 資料給使用者, 那就不需要網頁擷取這種技術了; 但事實上只有部分網站例如臉書或推特有提供 API 或 RSS, 絕大部分的網站都是從資料庫中提取資料後將其嵌在 HTML 網頁中輸出, 因此若要從目標網頁中撈取這些資訊就只能利用網路爬蟲了.

任何可用瀏覽器閱讀的內容都能用網路爬蟲程式抓下來進行剖析以擷取其中有價值之資訊, 然後透過程序排程器 (例如 crontab) 即可將原本需要手動經由瀏覽器查詢才能獲取資料進行分析預測的作業全部自動化, 因此網路爬蟲可說是現代的網路煉金術.

Python 有豐富的函式庫支援網頁擷取功能, 例如內建的 urllib, HTMLParser, 以及功能強大的第三方套件如 requests, ButterflySoup, Scrapy, 與 Sellenium 等方便好用工具, 因此 Python 可說是撰寫網路爬蟲的最佳語言.

不過利用網路爬蟲擷取公開網頁雖然基本上合法, 但實務上須注意下列事項 :
  1. 向網站伺服器提出網頁要求 (Request) 時須修改 HTTP 標頭 (Headers) 中的 User-Agent 選項偽裝成一般瀏覽器, 因為有些伺服器會阻擋非瀏覽器取得網頁.
  2. 下載同一網站網頁的頻率不可太高, 某些網站會封鎖高頻存取之 IP, 甚至以頻繁擷取影響伺服器穩定為由提起法律訴訟.  
  3. 擷取網頁內容作為私人用途沒有問題; 但若將其重新公開發布於自己的網站則可能有法律問題. 特別是有版權之網頁, 須注意勿違反其服務條款.
以下的測試參考了下列 Python 網頁擷取相關書籍 :
  1.  Python 網路爬蟲實戰 (松崗, 胡松濤)
  2.  Python 自動化的樂趣 (碁峰, AL Sweigart)
  3.  Python 程式設計實務 (博碩, 何敏煌)
  4.  Python 初學特訓班 (碁峰, 文淵閣工作室)
  5.  網站擷取 : 使用 Python (碁峰, Ryan Mitchell)
  6.  Python 入門邁向高手之路-王者歸來 (深石, 洪錦魁)
  7.  Python 程式設計入門指南 (碁峰, 蔡明志譯)
  8.  Web Scraping with Python (Packt, Richard Lawson)
  9.  Python Web Scraping Cookbook (Packt, Michael Heydt)
  10.  Automate the Boring Stuff with Python (Starch, AL Sweigart)
  11.  Introduction to Programming Using Python (Pearson, Y. Daniel Liang)
  12.  Python Web Scraping : Fetching data from the web (Packt, Katharine Jarmul)
  13.  Data Wrangling with Python (O'Reilly, Jacqueline Kazil & Katharine Jarmul)
  14.  Web Scraping with Python : Collecting Data from the Modern Web (O'Reilly, Ryan Mitchell) 
本系列之前的文章參考 :

# Python 學習筆記 : 安裝執行環境與 IDLE 基本操作
# Python 學習筆記 : 檔案處理
# Python 學習筆記 : 日誌 (logging) 模組測試
# Python 學習筆記 : 資料庫存取測試 (一) SQLite
# Python 學習筆記 : 資料庫存取測試 (二) MySQL


Pyhton 2.x 版在網頁擷取方面內建了 urllib 與 urllib2 兩種套件, 都是用來處理 URL 要求用的, 但其功能不同, 主要差異有兩點 :
  1. urllib2 可傳入 Request 物件來設定 URL 要求之標頭; 而 urllib 則只能傳入 URL 字串, 無法操縱標頭資訊, 例如利用竄改 USER AGENT 來進行偽裝.
  2. urllib 有一個 urlencode() 方法可用來產生 GET 查詢字串, 但 urllib2 卻沒有此方法. 
由於有這些差異, 使得用 Python 2.x 版擷取網頁時通常需要同時使用 urllib 與 urllib2. 參考 :

# Python: difference between urllib and urllib2
# What are the differences between the urllib, urllib2, and requests module?

但是在 Python 3 版已經將這兩個模組整合為 urllib 一個套件, 並將整個套件重組為 urllib.request, urllib.parse, urllib.error, urllib.robotparser 等四個模組 :

 模組 說明
 urllib.request 開啟並讀取 URL
 urllib.error 捕捉 urllib.requests 引起之例外
 urllib.parse 剖析 URL
 urllib.robotparser 剖析 robot.txt 檔

參考 :

# https://docs.python.org/3/library/urllib.html
# https://docs.python.org/2/library/urllib2.html

以下將以 Python 3 內建的 urllib 模組來擷取並剖析網頁.  


一. 使用 urllib.prase 解析 URL :

urllib 模組中的 urllib.parse 類別用來解析與組合 URL 字串, 此類別常用方法如下 :

 方法 說明
 urlparse(url) 解析傳入之 url, 傳回 ParseResult 物件
 urlunparse(parts) 將 urlparse() 拆解出來的 URL 部件組合回 URL 
 urljoin(base, url) 將 base 位址與 url 位址組合成絕對 URL 網址

urllib.parse.urlparse(url) 方法會解析傳入之 url 字串, 並將結果以 ParseResult 物件 (是一個 tuple) 傳回, 此物件包含下列屬性與方法 :
  1. sheme (協定)
  2. netloc (網址)
  3. path (路徑)
  4. params (參數)
  5. query (查詢)
  6. fragment (頁內錨點)
  7. geturl() 方法 
其中 scheme 是指 http, https 等協定; netloc 是網址或網域名稱; path 是資源檔案之路徑, query 是 ? 後面的查詢字串 fragment 則是 # 後面的頁內錨點 (params 不知是啥?), 參考 :

# https://en.wikipedia.org/wiki/Fragment_identifier 

urlunparse() 方法功能與 urlparse() 相反, 將 urlparse() 解析出來的 ParseResult 物件 (即 URL 的各成分組成之 Tuple) 傳入, 此方法會將其組合回完整之 URL. urljoin() 方法則是將傳入之 base 網址與 url 資源檔名兩部分組合為完整之 URL 網址, 若 base 含有資源檔名, 則將被第二參數 url 檔名取代 .

測試範例如下 :

>>> from urllib.parse import urlparse
>>> from urllib.parse import urlunparse
>>> from urllib.parse import urljoin
>>> urla="http://www.abc.com/abc.htm?a=1&b=2&c=3"  #有 query 字串
>>> result=urlparse(urla)
>>> type(result)
<class 'urllib.parse.ParseResult'>
>>> result
ParseResult(scheme='http', netloc='www.abc.com', path='/a/b/c/abc.php', params='', query='a=1&b=2&c=3', fragment='')
>>> result.scheme
'http'
>>> result.netloc
'www.abc.com'
>>> result.path
'/a/b/c/abc.php'
>>> result.params
''
>>> result.query
'a=1&b=2&c=3'
>>> result.fragment
''
>>> result.geturl()
'http://www.abc.com/a/b/c/abc.php?a=1&b=2&c=3'
>>> urlunparse(result) 
'http://www.abc.com/a/b/c/abc.php?a=1&b=2&c=3'
>>> urlb="http://www.abc.com/abc.htm#home"     #有 fragment
>>> urlparse(urlb)          #將 ParseResult 部件組合回完整 URL
ParseResult(scheme='http', netloc='www.abc.com', path='/abc.htm', params='', query='', fragment='home') 
>>> urljoin('http://www.abc.com/abc.htm', 'xyz.htm')     #替換 base 中的資源檔
'http://www.abc.com/xyz.htm'
>>> urljoin('http://www.abc.com', 'xyz.htm')       #串接 base 與資源檔
'http://www.abc.com/xyz.htm'


二. 使用 url.request 下載網頁 : 

urllib.request 是 Python 內建的網頁擷取模組, 其 urlopen() 方法是基於檔案處理的 open() 方法, 以 Connection: Close 標頭向指定之 URL, 向伺服器提出 HTTP/1.1 要求以下載並開啟網頁, 功能相當於 Python 2.x 版的 urllib2.urlopen(), 其 API 如下 :

urllib.request.urlopen(url, data=None, [timeout, ]*, cafile=None, capath=None, cadefault=False, context=None)

其中必要傳入參數 url 為欲開啟之 URL 字串或 Request 物件; data 為一個 urllib.request.Request 物件, 主要用來設定標頭資訊. 備選參數 timeout 用來指定 HTTP, HTTS, 以及 FTP 要求之逾時時間 (單位為秒), 未傳入時以全域預設值為準.

urllib.request.urlopen() 會傳回一個 http.client.HTTPResponse 物件, 可呼叫其 read() 方法來取得伺服器回應之訊息. 我之前在寫 PHP 爬蟲時所參考的 "Webbots, Spiders, And Screen Scrapers (No Starch Press, Michael Shrenk)" 一書中, 作者在其網站中提供了一個簡單的網頁可做為測試的標的 :

# http://www.webbotsspidersscreenscrapers.com/hello_world.html

這網頁很簡單, 就是顯示兩行文字而已. 其 HTML 原始碼如下 (Chrome 按 F12) :

<!DOCTYPE HTML PUBLIC "-//W3C//DTD HTML 4.0 Transitional//EN">

<html>
<head>
<title>Hello, world!</title>
</head>

<body>
Congratulations! If you can read this, <br>
you successfully downloaded this file.
</body>
</html>

將此網頁網址傳入 urllib.request.open() 即可下載此網頁並傳回 HTTPResponse 物件 : 

>>> import urllib.request    
>>> url="http://www.webbotsspidersscreenscrapers.com/hello_world.html"   
>>> response=urllib.request.urlopen(url)    
>>> type(respone)   
<class 'http.client.HTTPResponse'>       #傳回 HTTPResponse 物件
>>> response.read().decode()         #讀取網頁內容並以預設 utf-8 格式解碼
'<!DOCTYPE HTML PUBLIC "-//W3C//DTD HTML 4.0 Transitional//EN">\r\n\r\n<html>\r\n<head>\r\n\t<title>Hello, world!</title>\r\n</head>\r\n\r\n<body>\r\nCongratulations! If you can read this, <br>\r\nyou successfully downloaded this file.\r\n</body>\r\n</html>\r\n'

此處 response.read() 預設是讀取下載檔案之全部內容, 但也可以傳入整數指定要讀取幾個 bytes. response.read() 讀回來的是 Byte 類型資料, 需呼叫 decode() 來解碼, 可傳入明確之編碼類型例如 "big5" 或 "utf-8" (預設), 也可以呼叫 Response 物件的 headers 物件之 get_content_charset() 方法從回應訊息中取得回應網頁之編碼方式. 一般正常網頁都會在 meta 標籤中設定 charset, 例如 Yahoo 股市中台積電 2330 的股利政策網頁編碼是 big5 :

>>> url="http://tw.stock.yahoo.com/d/s/dividend_2330.html"   
>>> response=urllib.request.urlopen(url)   
>>> response.headers.get_content_charset()     #編碼為 big5
'big5'     
>>> content=response.read().decode(response.headers.get_content_charset())
>>> type(content)
<class 'str'>

要注意的是, decode() 之傳入參數為字串 (可以不傳參數), 不可傳入 None, 否則會出現錯誤訊息. 下面的範例中因原始網頁的 head 中沒有設定 charset, 回應訊息標頭中也不會有 charset, 因此呼叫 get_content_charset() 時回傳值為 None, 使得 decode() 出現錯誤.

>>> url="http://www.webbotsspidersscreenscrapers.com/hello_world.html" 
>>> response=urllib.request.urlopen(url)
>>> response.headers.get_content_charset()     #沒有設定編碼方式傳回 None
>>> content=response.read().decode(response.headers.get_content_charset())
Traceback (most recent call last):
  File "<pyshell>", line 1, in <module>
TypeError: decode() argument 1 must be str, not None 

如果要用 get_content_charset() 自動取得編碼, 最好加上 if else 來判別是否會傳回 None :

>>> response=urllib.request.urlopen(url)
>>> charset=response.headers.get_content_charset()
>>> if charset:
>>>      content=response.read().decode(chasrset)   #有傳回編碼
>>> else:
>>>      content=response.read().decode()      #沒有傳回編碼

總之, decode() 要嘛不傳參數進去, 否則一定要有字串傳給它.

下載的網頁經過讀取解碼後得到純文字的 HTML 碼, 必須利用剖析技術才能從 HTML 代碼中擷取出有價值的資訊.


三. 使用 HTMLParser 剖析網頁 :

Python 內建的 HTML 剖析器為 html.parser 模組中的 HTMLParser 類別, 它具有容錯能力可處理網路上各種怪異或不對稱的 HTML 代碼. 使用 html.parser 模組剖析網頁首先必須先從 html.parser 匯入 HTMLParser 類別 :

from html.parser import HTMLParser

此 HTMLParser 類別提供下列剖析工具 :

 HTMLParser 方法 說明
 feed(data) 將字串資料 data 餵給剖析器處理
 close() 關閉剖析器, 並強迫處理緩衝區資料
 reset() 重新啟始剖析器, 緩衝區資料將喪失
 getpos() 傳回剖析器目前處理的列與 offset
 get_starttag_text() 傳回最近一次開啟標籤之文字內容

然後定義一個繼承 HTMLParser 的自訂類別例如 MyHTMLParser, 並至少覆寫常用之  handle_starttag(), handle_endtag(), handle_startendtag(), 以及 handle_data() 等方法 :

class MyHTMLParser(HTMLParser):         #繼承 HTMLParser 類別
    def handle_starttag(self, tag, attrs):            #處理起始標籤
        print("Encountered a start tag:", tag)
    def handle_endtag(self, tag):                      #處理結束標籤
        print("Encountered an end tag :", tag)
    def handle_startendtag(self, tag):               #處理起始兼結束標籤 (單一)
        print("Encountered an end tag :", tag)
    def handle_data(self, data):                         #處理資料
        print("Encountered some data  :", data)

然後建立 HTMLParser 物件, 並呼叫此物件之 feed() 方法將 HTML 代碼餵給物件去剖析. 參考 :

# https://docs.python.org/3/library/html.parser.html
# HTML Parser: How to scrap HTML content
# Python urllib.parse.parse_qs() Examples

例如 :

import urllib.request
from html.parser import HTMLParser

class MyHTMLParser(HTMLParser):
    def handle_starttag(self, tag, attrs):
        print("Encountered a start tag:", tag)
    def handle_endtag(self, tag):
        print("Encountered an end tag :", tag)
    def handle_data(self, data):
        print("Encountered some data  :", data)

parser=MyHTMLParser()
url="http://www.webbotsspidersscreenscrapers.com/hello_world.html"
response=urllib.request.urlopen(url)
charset=response.headers.get_content_charset()
if charset:
    content=response.read().decode(chasrset)   #有傳回編碼
else:
    content=response.read().decode()
parser=MyHTMLParser()
parser.feed(content)

執行結果如下 :

Encountered some data  :

Encountered a start tag: html
Encountered some data  :

Encountered a start tag: head
Encountered some data  :

Encountered a start tag: title
Encountered some data  : Hello, world!
Encountered an end tag : title
Encountered some data  :

Encountered an end tag : head
Encountered some data  :

Encountered a start tag: body
Encountered some data  :

Congratulations! If you can read this,
Encountered a start tag: br
Encountered some data  :
you successfully downloaded this file.

Encountered an end tag : body
Encountered some data  :

Encountered an end tag : html
Encountered some data  :

參考 :

# [第 16 天] 網頁解析
# python 3 筆記 - 利用urllib來存取網頁
# https://docs.python.org/3/library/html.parser.html
# html.parser — Simple HTML and XHTML parser
# How to handle response encoding from urllib.request.urlopen()
# 網路機器人、網路蜘蛛與網路爬蟲 PHP/CURL程式設計指南
# 讀後心得 : 一輩子餓不死的技能
# Top 10 Best Web Scraping Books
# Web Scraping in Python using Scrapy
# How To Crawl A Web Page with Scrapy and Python 3
# Web Scraping Tutorial with Python: Tips and Tricks
# Data Analytics with Python by Web scraping: Illustration with CIA World Factbook
# Apress 新書 : Practical Web Scraping for Data Science
# 新書 : Web Scraping for Data Science with Python (絕版)
# Intro to Web Scraping with Python and Beautiful Soup
# Python Web Scraping & Sentiment Analysis Tutorial For Beginners
# Web-Scraping for Data Science – Part 1
# Web Scraping for Data Science — Part 2
# Should Data Scientists Learn Web Scraping?
# 5 Tasty Python Web Scraping Libraries
# Web Scraping And Analytics With Python
# Coursera : Using Python to Access Web Data
# General Tips for Web Scraping with Python
# Tutorial: How to do web scraping in Python?
# Web Crawling - UCI (PDF)
# Python programming — text and web mining (PDF)
# Web Crawling and Scraping using Python, Selenium, and PhantomJS
# Coursera : Capstone: Retrieving, Processing, and Visualizing Data with Python
# How to handle response encoding from urllib.request.urlopen()
# Python爬虫入门:Urllib parse库使用详解(二)
# HTML Parser: How to scrap HTML content